

Modelowanie tematów z Sentence BERT
 Autor: VoicelabVoiceLab
Jednym z kluczowych zadań w rozumieniu języka jest modelowanie tematów. Nasze umysły, zdolne do wysokiej abstrakcji, chwytają tematy dość łatwo. W naturalny sposób rozumiemy kontekst rozmowy czy tekstu pisanego. Ale czym właściwie jest temat?
Według Cambridge Dictionary temat (topic) to:
przedmiot, który jest omawiany, opisywany lub badany.
Modelowanie tematów polega na przygotowywaniu narzędzi, modeli lub algorytmów, które pomagają ustalić, jaki przedmiot jest omawiany, poprzez analizę ukrytych wzorców. Takie modele tematów są często używane do wykrywania zmian tematu w tekście, w eksploracji danych z sieci (web mining) lub do grupowania rozmów. To doskonałe narzędzie do wyszukiwania informacji, szybkiego streszczania dużych korpusów albo metoda selekcji cech. Na przykład w Voicelab używamy modelowania tematów, aby szybko kategoryzować teksty i transkrypcje oraz odkrywać wewnętrzne wzorce w rozmowach.
Poniżej znajduje się przykład analizy setek rozmów
za pomocą naszego wrażliwego na tematy modelu kwT5.
Dane w modelowaniu tematów
Aby jednak wytrenować takie modele, potrzebujemy danych. Mnóstwa danych. Można do tego podejść na kilka sposobów. Niektórzy eksperymentują z uczeniem nadzorowanym - ale klasyczny trening nadzorowany wymaga ręcznie oznaczonych danych. Istnieją jednak podejścia, które nie wymagają danych z adnotacjami (uczenie nienadzorowane). Badacze próbowali na przykład generować embeddingi (osadzenia) słów lub zdań za pomocą wstępnie wytrenowanych modeli językowych, takich jak BERT czy Word2Vec, a następnie je klastrować. Niektórzy stosowali metody statystyczne, takie jak Latent Dirichlet Allocation (LDA), która przedstawia dokumenty jako mieszaniny tematów generujących słowa z określonymi prawdopodobieństwami. Inni korzystają z podejść takich jak KeyBert. KeyBert wyznacza reprezentacje na poziomie dokumentu (lub rozmowy) i za pomocą podobieństwa cosinusowego porównuje je z najbardziej podobnymi słowami w dokumencie. Pozwala to wydobyć frazy kluczowe, które często są ściśle związane z przedmiotem dyskusji.
Te metody są dobre, ale wciąż nie idealne. Modele BERT działają świetnie, ale ich proces pretreningu nie został zaprojektowany z myślą o modelowaniu tematów. A LDA nie radzi sobie zbyt dobrze z uchwyceniem trudniejszych, abstrakcyjnych pojęć. Tu z pomocą przychodzi podejście samonadzorowane.
Uczenie samonadzorowane
Ten rodzaj uczenia wykorzystuje nieoznaczone dane i tworzy zadanie pretekstowe (pretext task) do wykonania. Możemy na przykład wziąć duży korpus i próbować przewidzieć następne słowo dla danego zdania. Albo usunąć pojedyncze słowo i próbować je przewidzieć. Zwykle w każdym zadaniu pretekstowym część danych jest widoczna, a część ukryta. Zadanie polega na przewidzeniu ukrytych danych albo jakiejś ich właściwości. Dlaczego więc nie spróbować zdefiniować zadania pretekstowego ściśle związanego z modelowaniem tematów?
Zadanie pretekstowe to zadanie uczenia samonadzorowanego, które rozwiązuje się po to, by nauczyć się znaczących reprezentacji, a następnie wykorzystać te reprezentacje lub uzyskane w tym procesie wagi modelu w zadaniu docelowym.
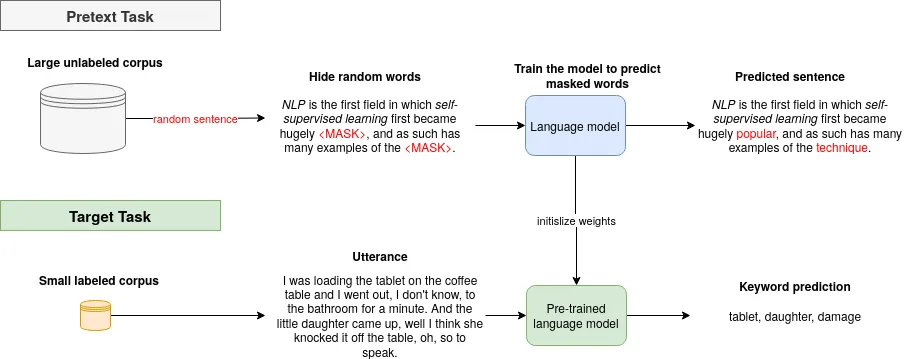
Więcej o zadaniach pretekstowych przeczytasz tutaj.
Sentence Bert
Skoro wiemy już, czym jest zadanie pretekstowe, skupmy się na zadaniu tematycznym do pretreningu naszych modeli NLP. W 2019 roku zaproponowano ciekawy model wykorzystujący syjamskie modele BERT do zadania semantycznego podobieństwa tekstów (STS).
Semantyczne podobieństwo tekstów określa, jak bardzo podobne są do siebie dwa fragmenty tekstu.
W artykule wykorzystano ogromny, otwarty i dobrze znany korpus tekstów dostępny w wielu językach: Wikipedię. Artykuły w Wikipedii są podzielone na sekcje poświęcone konkretnym zagadnieniom. Dlatego zdania z tej samej sekcji są sobie tematycznie bliższe niż zdania z różnych sekcji. Oznacza to, że możemy łatwo utworzyć duży zbiór danych ze słabo oznaczonymi trójkami zdań:
- Kotwica (zdanie bazowe)
- Przykład pozytywny pochodzący z tej samej sekcji
- Przykład negatywny z innej sekcji
Wszystkie przykłady w jednej próbce powinny pochodzić z tego samego artykułu.
Spójrzmy na przykład na artykuł o NLP w Wikipedii.
Weźmy kotwicę z sekcji History (Historia):
Do lat 80. XX wieku większość systemów przetwarzania języka naturalnego opierała się na złożonych zestawach ręcznie pisanych reguł.
Teraz losowo wybierzmy przykład pozytywny z tej samej sekcji History:
W latach 2010. uczenie reprezentacji i metody uczenia maszynowego oparte na głębokich sieciach neuronowych upowszechniły się w przetwarzaniu języka naturalnego.
Teraz jedno losowe zdanie z innej sekcji, Methods: Rules, statistics, neural networks (Metody: reguły, statystyka, sieci neuronowe), ale wciąż z tego samego artykułu:
Główną wadą metod statystycznych jest to, że wymagają rozbudowanej inżynierii cech.
Korzystając z mniej niż tysięcy artykułów, możemy wygenerować tysiące unikalnych przykładów dla dowolnego języka dostępnego w Wikipedii. Ponieważ Voicelab.ai jest polską firmą, zdecydowaliśmy się na język polski i polską Wikipedię.
Mamy przykłady. Co dalej?
Chcemy zmodyfikować parametry modelu tak, aby reprezentacje generowane dla zdań na ten sam temat były do siebie bardziej podobne niż reprezentacje zdań z innych dyskusji. Dlatego w kolejnym kroku próbujemy:
- zwiększyć podobieństwo reprezentacji kotwicy i przykładu pozytywnego
- zmniejszyć podobieństwo reprezentacji kotwicy i przykładu negatywnego
I dokładnie to robi funkcja straty triplet loss.
Triplet loss to funkcja straty dla algorytmów uczenia maszynowego, w której wejście referencyjne (zwane kotwicą) porównuje się z wejściem pasującym (zwanym pozytywnym) i niepasującym (zwanym negatywnym). Odległość od kotwicy do przykładu pozytywnego jest minimalizowana, a odległość od kotwicy do wejścia negatywnego - maksymalizowana.
Podsumowując, kolejne kroki wyglądają tak:
- pobierz próbki: jedna próbka składa się z kotwicy, przykładu pozytywnego i przykładu negatywnego
- wygeneruj modelem (np. BERT) reprezentacje dla każdej próbki
- oblicz odległość (np. cosinusową lub euklidesową) między kotwicą a przykładem pozytywnym oraz między kotwicą a przykładem negatywnym
- za pomocą triplet loss zminimalizuj odległość między kotwicą a przykładem pozytywnym i zmaksymalizuj odległość między kotwicą a przykładem negatywnym
Embeddingi możemy po prostu porównać za pomocą `TripletMarginWithDistanceLoss` z PyTorch.
SentenceBert w praktyce
Skoro wiemy i rozumiemy, jak działają SentenceBert i triplet loss, możemy przejść do kodu. Najpierw pobierzmy najnowszy zrzut Wikipedii. Następnie musimy przygotować trójki danych. Trzeba wczytać artykuły z Wikipedii i podzielić je na sekcje. Potem dla każdej sekcji tworzymy listę zdań. Na koniec możemy przygotować zbiór danych w torch. Pseudokod zbioru danych przedstawiono poniżej.
class WikiTripletsDataset(Dataset):
    def __init__(self, data_path):
        with open(data_path) as json_file:
            wiki_json = json.load(json_file)
        triplets = list()
        for article in wiki_json:
            # get random section from one article
            anchor_section_nr, negative_section_nr = get_section_nr(article["sections"])
            # get random sentence from selected sections
            anchor, positive, negative = get_senctence_from_section(anchor_section_nr,
                                                                    negative_section_nr,
                                                                    article["sections"])
            triplets.append([anchor, positive, negative])
        self.samples = triplets
    def __len__(self):
        return len(self.samples)
    def __getitem__(self, idx):
        return self.samples[idx][0], self.samples[idx][1], self.samples[idx][2]
Kolejny krok to przygotowanie modelu. W konstruktorze musimy zdefiniować części modelu: tutaj do generowania reprezentacji używamy modelu `transformer` z Hugging Face (`self.model = AutoModel.from_pretrained(model_path)`). Dodatkowo dodajemy regularyzację w postaci `dropout`, aby zapobiec przeuczeniu. Ponieważ tokenizujemy dane podczas treningu, a nie w zbiorze danych, musimy zdefiniować tokenizer: `self.tokenizer = AutoTokenizer.from_pretrained(model_path)`. Spójrzmy na nasz kod w PyTorch:
class SentenceBertModel(pl.LightningModule):
    """Sentence Bert Polish Model for Semantic Sentence Similarity"""
    def __init__(self, model_path):
        super().__init__()
        self.model = AutoModel.from_pretrained(model_path).cuda()
        self.tokenizer = AutoTokenizer.from_pretrained(model_path)
        self.triplet_loss = nn.TripletMarginWithDistanceLoss(
            swap=True, margin=1)
        self.dropout = nn.Dropout(p=0.2)
    def forward(self, sentence, **kwargs):
        # tokenize sentence
        tokens = self.tokenizer(
            list(sentence), padding=True, truncation=True, return_tensors='pt')
        # pass through the transformer model
        x = self.model(tokens["input_ids"].cuda(),
                    attention_mask=tokens["attention_mask"].cuda()).pooler_output
        x = self.dropout(x)
        return x
Aby uprościć potok ML, używamy pytorch_lightning. Framework zaprojektowano z myślą o profesjonalnych i akademickich badaczach zajmujących się AI. Jak mówią jego autorzy: „PyTorch ma wszystko, czego potrzebujesz do trenowania modeli, jednak uczenie głębokie to znacznie więcej niż łączenie warstw”. Gdy przychodzi do właściwego treningu, trzeba napisać sporo powtarzalnego kodu (boilerplate), a jeśli chcemy skalować trening lub wnioskowanie na wiele urządzeń czy maszyn, czeka nas kolejny zestaw integracji.
Poniżej przedstawiono przykładowy krok treningowy dla SentenceBert. Najpierw pobieramy nowy batch danych prosto z naszego zbioru danych. Następnie przekazujemy dane do funkcji `forward()`. Wykonuje się wszystko, co znajduje się w `forward`, a my otrzymujemy z powrotem reprezentacje. Embeddingi porównujemy za pomocą `TripletMarginWithDistanceLoss` z PyTorch.
def training_step(self, batch, batch_idx):
    anchor, positive, negative = batch
    # generate representations
    anchor_embedding = self(anchor)
    positive_embedding = self(positive)
    negative_embedding = self(negative)
    # calculate triplet loss
    loss = self.triplet_loss(
        anchor_embedding, positive_embedding, negative_embedding)
    return {'loss': loss}
def validation_step(self, batch, batch_idx):
    anchor, positive, negative = batch
    # generate representations
    anchor_embedding = self(anchor)
    positive_embedding = self(positive)
    negative_embedding = self(negative)
    # calculate triplet loss
    loss = self.triplet_loss(
        anchor_embedding, positive_embedding, negative_embedding)
    self.log("validation_loss", loss)
Teraz wystarczy uruchomić trening i poczekać.
import argparse
from torch.utils.data import DataLoader
import pytorch_lightning as pl
from dataset import WikiTripletsDataset
from model import SentenceBertModel
def get_args_parser():
    # arguments
    return parser
def main(args):
    # load custom datasets
    train_dataset = WikiTripletsDataset(args.train_path)
    val_dataset = WikiTripletsDataset(args.test_path)
    # pack data in batches
    dataloader_train = DataLoader(train_dataset, shuffle=True, batch_size=args.batch_size,
                                  num_workers=args.workers, drop_last=False)
    dataloader_val = DataLoader(val_dataset, shuffle=False, batch_size=args.batch_size,
                                num_workers=args.workers, drop_last=False)
    # define model
    model = SentenceBertModel(model_path=args.model_path)
    # set trainer
    trainer = pl.Trainer(max_epochs=args.epochs)
    # run training
    trainer.fit(model, dataloader_train, dataloader_val)
if __name__ == '__main__':
    parser = get_args_parser()
    args = parser.parse_args()
    main(args)
Gotowe! Twój model jest gotowy do użycia. Jeśli nie chcesz samodzielnie trenować SentenceBert, możesz skorzystać z naszego polskiego modelu SentenceBert, który jest dostępny tutaj.
Autor: Agnieszka Mikołajczyk