

Trend uczenia samonadzorowanego w rozpoznawaniu mowy
 Autor: VoicelabVoiceLab
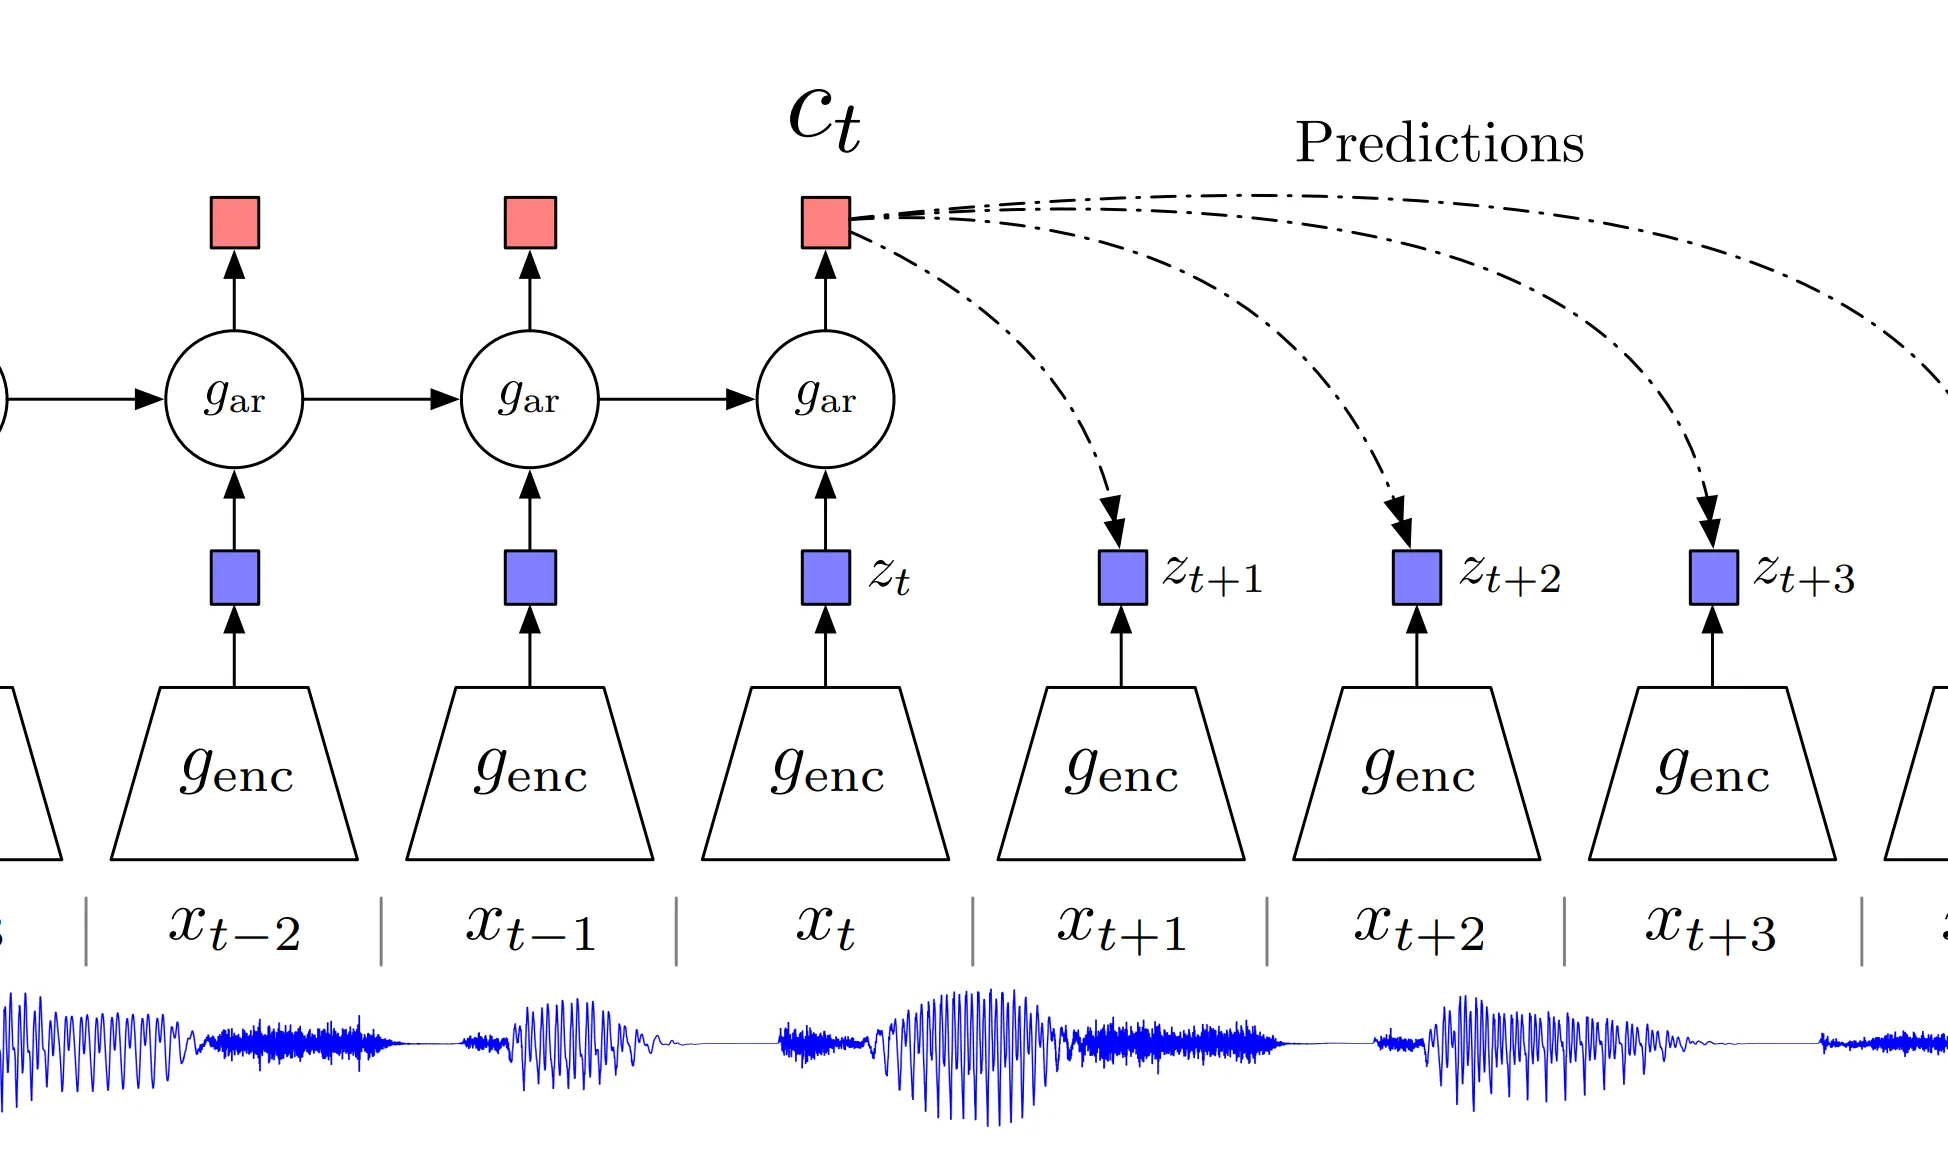
Samonadzorowany pretrening (self-supervised pre-training) to jedna z najbardziej obiecujących metod w dziedzinie uczenia głębokiego. Po wizji komputerowej i przetwarzaniu języka naturalnego stał się ostatnio jednym z najpopularniejszych tematów badań nad automatycznym rozpoznawaniem mowy (ASR). Zaproponowane Contrastive Predictive Coding (CPC) (link) pokazało duży potencjał wykorzystania nieoetykietowanych danych w klasyfikacji fonemów i mówców. Zapoczątkowało to ogromny wysiłek prowadzony przez wielkie firmy technologiczne, by jak najlepiej wykorzystać ocean nieoetykietowanych danych mowy dostępnych obecnie w internecie.
Temat jest tak atrakcyjny ze względu na wysoki koszt etykietowania dużych ilości danych do trenowania systemów rozpoznawania mowy. Obecne komercyjne korpusy ASR mogą kosztować nawet kilkaset dolarów za godzinę danych. Przykładem jest American English Speech Recognition Corpus (Mobile) od ELRA (link), który kosztuje 6000 € za 14,67 godziny mowy. Jeśli połączymy to z obserwacją, że aby zmniejszyć współczynnik błędów słów (WER) o 50% w modelu sieci neuronowej (link), zbiór danych musi wzrosnąć dziesięciokrotnie, dochodzimy do wniosku, że opłacalne jest osiągnięcie tylko pewnego poziomu WER - powyżej niego zyski niweluje finansowy koszt zakupu lub etykietowania nowych danych. Co więcej, osiągnięcie zadowalającego WER przy użyciu zbiorów transkrybowanego audio jest praktyczne tylko dla najpopularniejszych języków, w których baza klientów jest znacznie większa. Dlatego wielkie firmy technologiczne i reszta branży skupiły się na poszukiwaniu innych, lepiej skalujących się rozwiązań.
Od czasu oryginalnego artykułu o CPC i jego rozwinięcia wav2vec (link), które jako pierwsze pokazało, że pozwala osiągnąć wyniki porównywalne z najlepszymi (state-of-the-art, SOTA) na powszechnie używanym zbiorze danych, pojawiła się fala artykułów i badań, które rozwijały i rozszerzały pierwotną pracę, łączyły ją z istniejącymi badaniami albo po prostu stosowały do innych zadań lub domen. Najważniejsza praca wykorzystuje wav2vec2.0 (link), który pobił wyniki SOTA na zbiorach LibriSpeech (oetykietowany) + LibriLight (nieoetykietowany). Osiągnięto to dzięki innej obiecującej metodzie: Noisy Student Training (link), znanej też jako pseudoetykietowanie (Pseudo Labelling) (link), której poświęcimy wkrótce osobny wpis. Największą zaletą obu metod jest to, że można je skutecznie łączyć (link, link). Główną wadą wav2vec2.0 w porównaniu z CPC czy wav2vec jest to, że używa dużego modelu Transformer z pełnym kontekstem i procedury treningu opartej na maskowaniu, więc nie można go użyć w systemie ASR o niskim opóźnieniu.
Przegląd Contrastive Predictive Coding - proponowanego podejścia do uczenia reprezentacji.
Choć na rysunku wejściem jest audio, tego samego układu używamy dla obrazów, tekstu i uczenia ze wzmocnieniem. (źródło)
Główną ideą uczenia samonadzorowanego jest nauczenie się pewnej reprezentacji sygnału wejściowego, która może być użyteczna w zadaniu docelowym (downstream). W tym celu musimy zdefiniować funkcję straty, dzięki której model nauczy się czegoś sensownego. Funkcje straty zarówno oryginalnego CPC, jak i wav2vec2.0 są inspirowane stratami używanymi w modelowaniu języka. Modele języka oparte na rekurencyjnych sieciach neuronowych (link) trenowano tak, by przewidywały następne słowo, mając na wejściu bieżące słowo, a jako kontekst wszystkie poprzednie słowa. Ten paradygmat zmusza sieć neuronową do nauczenia się reprezentacji każdego słowa i ich kombinacji, aby mogła przewidzieć, które kolejne słowa mają sens w danym kontekście. W ten sposób uczy się ona struktury języka wyłącznie na podstawie dużej ilości tekstu, który bardzo łatwo zdobyć w dużych ilościach. Mając taki wstępnie wytrenowany model, można go dostroić (fine-tuning) do bardziej precyzyjnego zadania, w którym danych jest znacznie mniej, np. klasyfikacji tekstu (link). Podobnie jest z CPC, ale ze względu na niejasne granice w sygnale mowy, jego zmienność i gęstość próbek (zwykle 8 tys. lub 16 tys. na sekundę) potrzebna jest ukryta (latentna) reprezentacja sygnału, aby zadanie predykcji było rozsądne. Wprowadza to do modelu nowy problem: może on po prostu „zapaść się” (collapse), zerując reprezentację latentną i osiągając 100% dokładności. Aby temu zapobiec, zaproponowano zadanie kontrastowe: odróżnianie kolejnych ramek od N losowo wybranych, co wymusza zróżnicowanie reprezentacji. Ponieważ sygnał mowy może pozostawać dłużej w niektórych fonemach niż w innych, aby dać modelowi silniejszą motywację do nauki, ustawia się go tak, by przewidywał więcej niż jedną kolejną reprezentację latentną. Zapobiega to prostej predykcji, że wektor latentny zawsze pozostanie taki sam - co byłoby prawdą przez znaczną część czasu. Połączenie tych elementów dało autorom metodę skutecznego trenowania modelu, który osiągnął obiecujące wyniki zarówno w klasyfikacji fonemów, jak i mówców. Kolejny model, wav2vec, udowodnił, że metoda ta sprawdza się jako pretrening modeli akustycznych (AM) dla ASR.
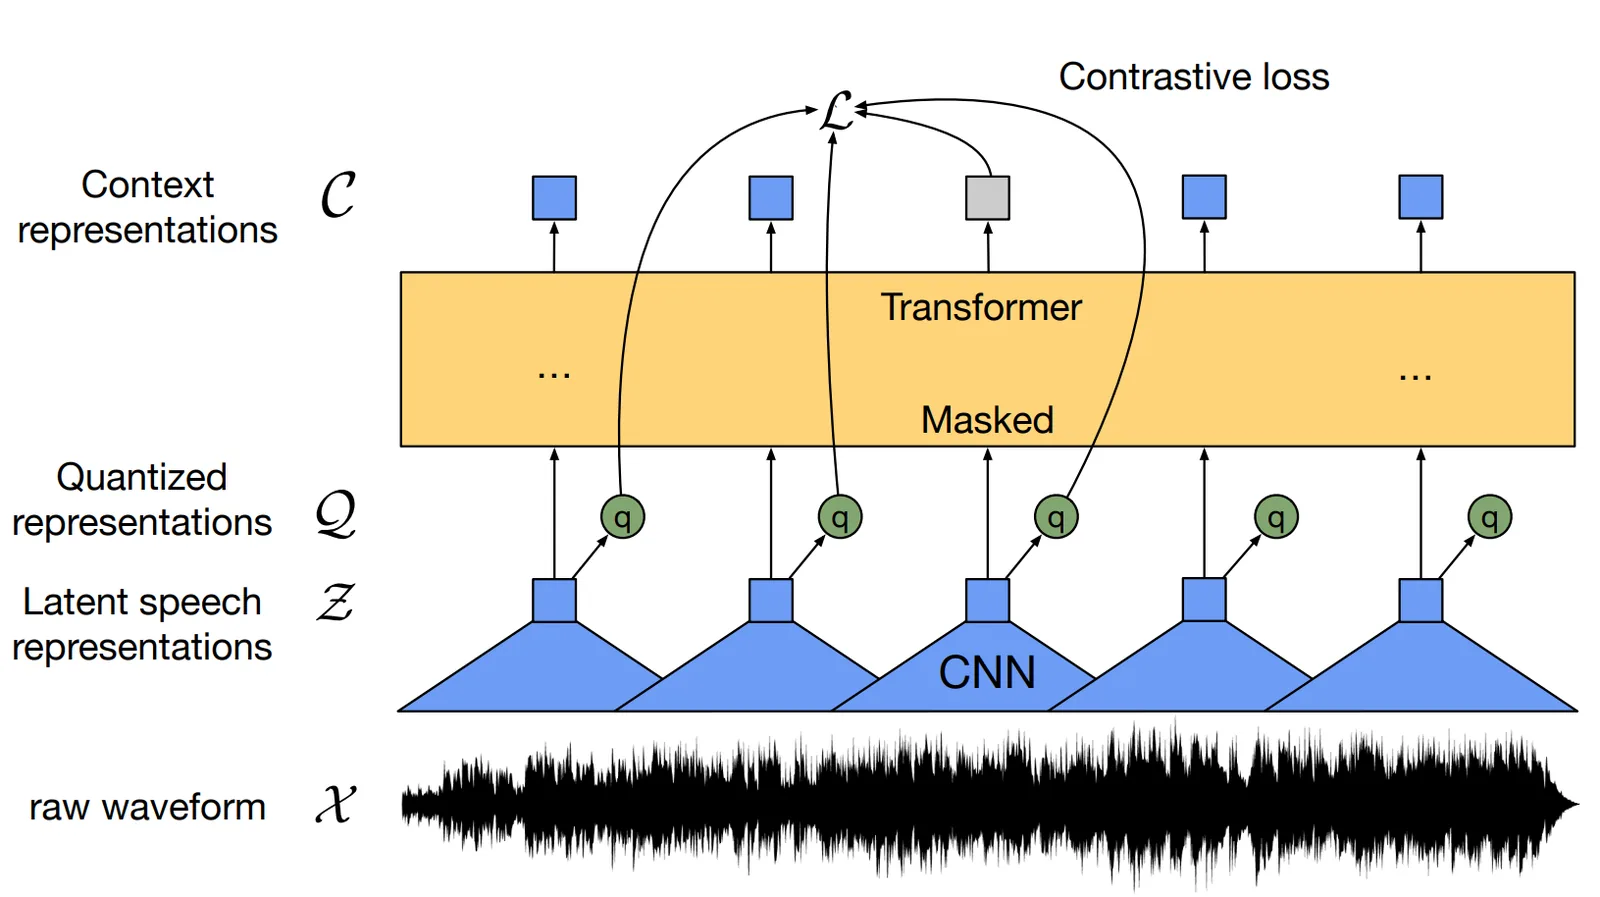
Ilustracja architektury, która jednocześnie uczy się kontekstowych reprezentacji mowy i inwentarza dyskretnych jednostek mowy. (źródło)
Model wav2vec2.0 był inspirowany modelem BERT (link), w którym - ponieważ model potrzebuje pełnego przyszłego kontekstu - przewidywanie następnego tokenu było niewykonalne. Aby to obejść, zaproponowano maskowane modelowanie języka (Masked Language Modeling, MLM), w którym część tokenów wejściowych jest maskowana, a model musi je przewidzieć. W wav2vec2.0 model jest trenowany w stylu MLM, ale na skwantyzowanych reprezentacjach latentnych. Wymusza to użycie straty kontrastowej, Gumbel SoftMax (link) oraz straty różnorodności (diversity loss) (link), która zachęca do wykorzystania wszystkich klas. Użycie potężnych Transformerów i procedur podobnych do MLM umożliwiło wartościowy pretrening i zmniejszyło zapotrzebowanie na dane oetykietowane, dając świetne wyniki także dla innych języków, które nie były uwzględnione w pretreningu (link). Dalsze badania próbują coś do tego dodać, np. offline'owe klastrowanie podobnych ramek w celu odkrycia ukrytych jednostek w HUBERT (link), dodatkowe funkcje straty (link, link), które dają niewielkie zyski lub większą odporność w niektórych domenach, albo po prostu skalowanie (link). Dużym problemem tych modeli jest koszt pretreningu, który dla oryginalnego wav2vec2.0 wynosił ok. 16 000 GPU-godzin [5], a także jego niestabilność (link, link). Wzięcie wszystkich dostępnych danych i wrzucenie ich do modelu nie jest więc najlepszym pomysłem. Poza tym, choć modele świetnie radzą sobie z danymi z tej samej domeny, w zetknięciu z domenami bardziej odległymi od danych użytych w pretreningu działają już nie tak dobrze (link). Proponowanym rozwiązaniem jest kontynuacja pretreningu na danych z domeny docelowej. Daje to dużą redukcję WER, nawet jeśli dane do dostrajania nie pochodzą z domeny docelowej, ale wciąż wymaga dużej ilości nieoetykietowanych danych docelowych, aby naprawdę zrobić różnicę. Pod względem generalizacji społeczność zajmująca się mową wciąż ma więc wiele do odkrycia, nawet poza samym obszarem treningu samonadzorowanego (link).
Samonadzorowany pretrening to duży krok w stronę udostępnienia rozpoznawania mowy dla rzadziej używanych języków, zwłaszcza dzięki otwartości wielkich firm i społeczności uczenia maszynowego, które udostępniają modele wraz ze swoimi badaniami. Gdyby tak nie było, pretrening takich modeli byłby nieosiągalny dla większości badaczy i małych firm ze względu na ogromny koszt obliczeń na GPU. Mimo to wyjście poza domeny docelowe samo w sobie niesie wiele wyzwań. Co więcej, w miarę jak badania zmierzają ku coraz większym modelom (link), wkrótce zetkniemy się z rozmiarami na miarę Megatron-Turing NLG (link, link), dostępnymi wyłącznie dla firm o dużych możliwościach finansowych. Podsumowując: choć sprzęt rozwija się w zawrotnym tempie, najbardziej potrzebują ulepszenia metody trenowania tak ogromnych modeli - najlepiej takie, które zmniejszą koszt obliczeniowy do ułamka obecnego. Miejmy nadzieję, że przełom w tej kwestii nastąpi już wkrótce.
Autor: Jakub Kaliski