

Przetransformuj mnie!
 Autor: VoicelabVoiceLab
Co przychodzi ci na myśl, gdy słyszysz „Transformer”? Robot? Element obwodu elektrycznego? A może sieć neuronowa? Jeśli chcesz dowiedzieć się czegoś o tej ostatniej, zapraszamy do lektury!
Transformer
Transformery to rodzina sieci neuronowych stosowanych głównie w przetwarzaniu języka naturalnego (NLP). Zostały przedstawione stosunkowo niedawno - w 2017 roku przez Vaswaniego i współpracowników w artykule „Attention Is All You Need” (link). Efektowny tytuł rzeczywiście oddaje główną ideę tej architektury.
Wcześniej w NLP stosowano głównie rekurencyjne sieci neuronowe (RNN). Choć dawały zadowalające wyniki, miały wadę w postaci długiego czasu obliczeń, ponieważ przetwarzają naraz długą sekwencję słów. Na ratunek przychodzą tu transformery, bo nie operują na całej sekwencji, lecz wyłącznie na relacjach uwagi między embeddingami (osadzeniami), czyli numerycznymi reprezentacjami słów.
Czym właściwie jest mechanizm uwagi?
Wcześniejsze architektury opierały się na strukturze koder-dekoder. Koder musiał utworzyć wektor reprezentujący zdanie wejściowe, który następnie był przekazywany jako wejście do dekodera.
Mechanizm uwagi zakłada przekazanie do dekodera wszystkich stanów kodera, dzięki czemu model może sam wybrać, które informacje uważa za najważniejsze.
Na rysunku 1 widać ideę mechanizmu uwagi w procesie tłumaczenia. Choć pomysł może wydawać się prosty, był przełomem w dziedzinie przetwarzania języka naturalnego.
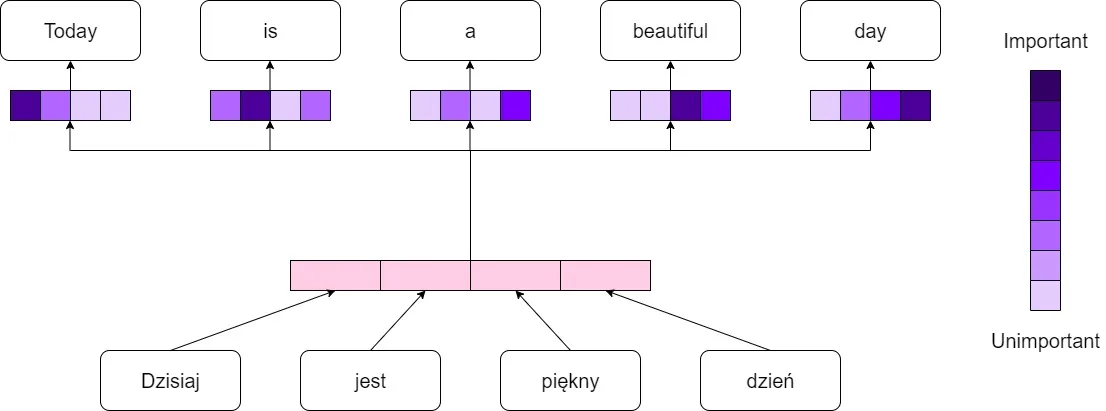
W przypadku mechanizmu samouwagi (self-attention) różnica polega na tym, że wybór najważniejszej części wejścia odbywa się już w trakcie kodowania - elementy wejścia oddziałują na siebie nawzajem, przyznając sobie „punkty uwagi”.
Architektura Transformera
Jak widać na rysunku 2, koder składa się z n warstw, z których każda zawiera dwie podwarstwy. Pierwsza to Multi-Head Attention, która niezależnie uczy się samouwagi między słowami, a druga to w pełni połączona sieć jednokierunkowa (feed-forward). Podwarstwy są połączone połączeniami rezydualnymi, po których następuje blok normalizacji.
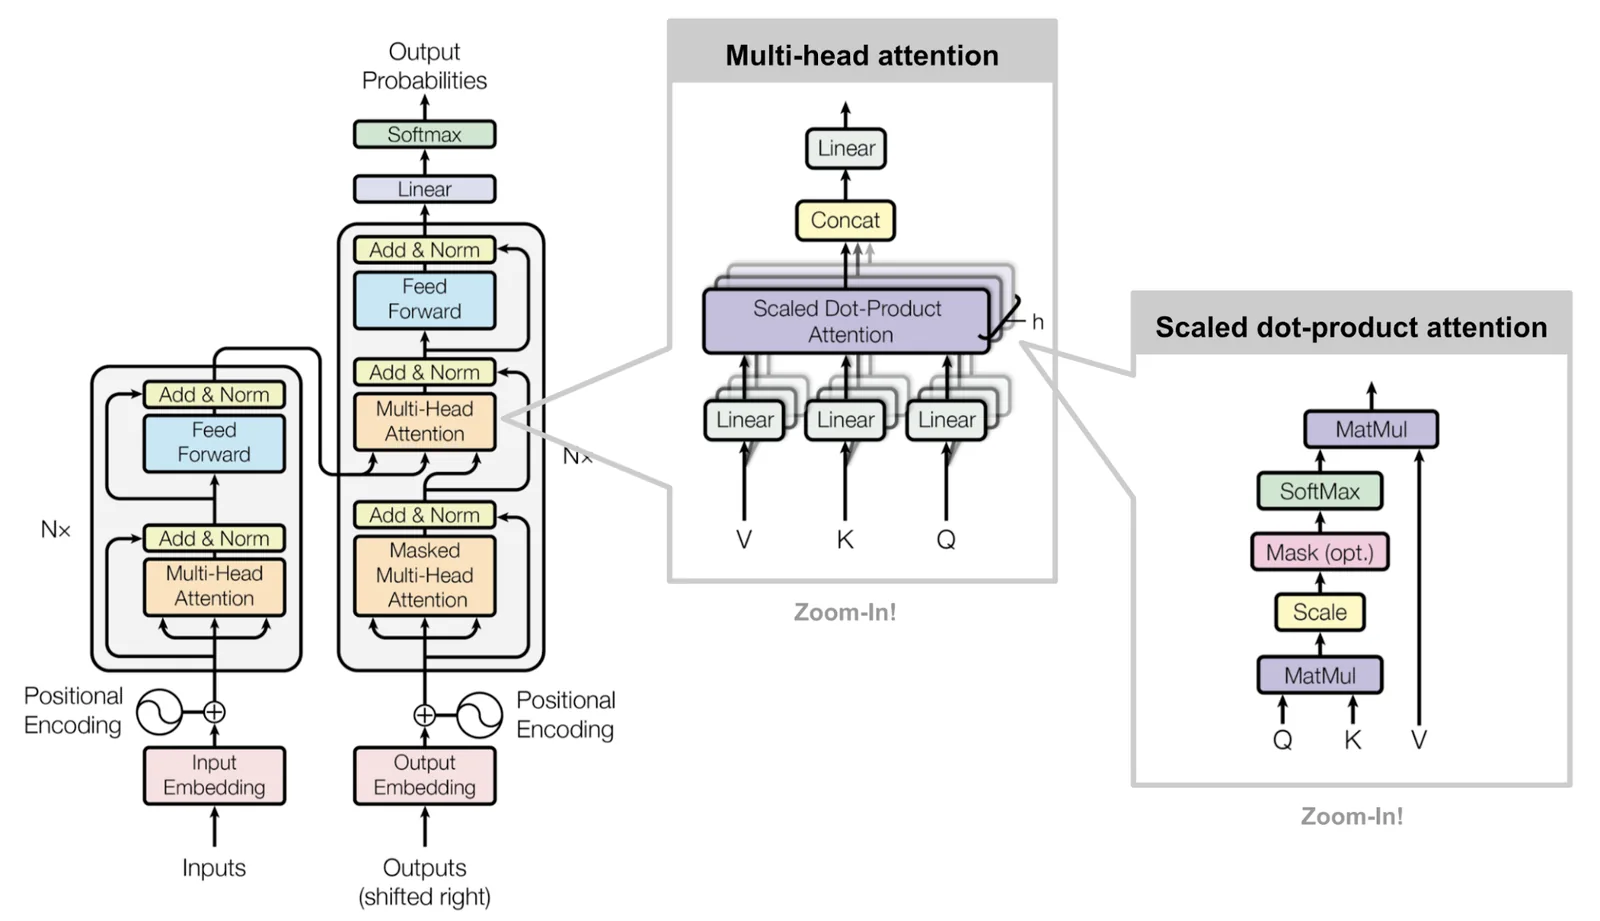
Dekoder ma dość podobną strukturę, jednak każda jego warstwa zawiera dodatkowo trzecią podwarstwę - Multi-Head Attention nad wyjściem kodera.
Mechanizm Multi-Head Attention działa na trzech wektorach - Query, Key i Value. Query można traktować jako bieżące słowo (embedding), a Value jako informację, którą ono niesie. Key to po prostu forma uporządkowania wartości, podobnie jak indeksowanie.
Zastosowania w praktyce
Transformery pozwalają analizować tekst z innej perspektywy - nie jako sekwencję słów, lecz raczej jako sedno komunikatu. To ogromna zaleta, ponieważ szyk wyrazów w zdaniu zwykle różni się w zależności od języka, mówiącego itp. Choć transformery są wydajniejsze obliczeniowo, do treningu potrzebują ogromnej ilości danych, co jest typowym problemem w uczeniu maszynowym.
Na szczęście istnieją modele, które można wykorzystać jako punkt wyjścia do uczenia transferowego, np. HerBERT (link). Model ten został przedstawiony w 2021 roku przez polskich naukowców z Allegro.pl. Opiera się na BERT - najbardziej znanym modelu NLP stworzonym przez Google - i jest dostosowany do trudnego języka polskiego. W klasyfikacji KLEJ osiągnął 88,4 na 100 punktów, co jest najlepszym wynikiem (state of the art) wśród polskich modeli.
Aby użyć modelu, wystarczy zapisać to tak:
from transformers import AutoTokenizer, AutoModel

tokenizer = AutoTokenizer.from_pretrained("allegro/herbert-base-cased")
model = AutoModel.from_pretrained("allegro/herbert-base-cased")

output = model(
    **tokenizer.batch_encode_plus(
        [
            (
                "Język - ukształtowany społecznie system budowania wypowiedzi, używany w procesie komunikacji.",
                "Język służy do przedstawiania rzeczywistości dotyczącej przedmiotów, czynności czy abstrakcyjnych pojęć za pomocą znaków.",
            )
        ],
    padding='longest',
    add_special_tokens=True,
    return_tensors='pt'
    )
)
W tym przypadku musisz zdefiniować tokenizer - narzędzie dzielące wejście na osobne tokeny, czyli słowa - oraz model, którego chcesz użyć, tj. herbert-base-cased. Jako wejście modelu podajesz stokenizowany tekst.
W zależności od tego, co chcesz osiągnąć, możesz używać HerBERT-a z odpowiednią głowicą (Head Model) do różnych celów, np.:
- przewidywania zamaskowanego słowa w zdaniu,
- przewidywania następnego słowa,
- przewidywania następnego zdania,
- odpowiadania na pytania
Jako wynik otrzymujesz oczekiwane słowo lub sekwencję słów.
Vision Transformer
Widzenie komputerowe (Computer Vision) to jedna z dziedzin, w których uczenie maszynowe budzi największe zainteresowanie. Większość rozwiązań dotyczy problemów wizyjnych. Nawet sygnał bywa przed analizą przekształcany do „postaci obrazu”, a dopiero potem przetwarzany przez sieć. Skoro tak, dlaczego nie spróbować operacji odwrotnej?
Zastosowanie Transformera w rozpoznawaniu obrazów przedstawili w 2020 roku Dosovitskiy i współpracownicy w artykule „An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale” (link).
Architektura
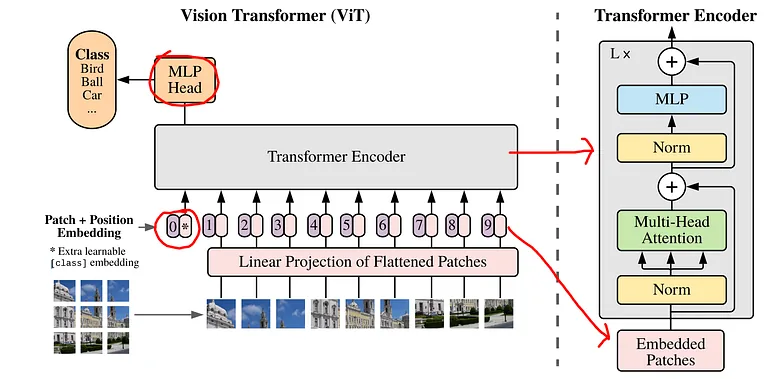
Główna idea polegała na podzieleniu obrazu na mniejsze fragmenty (patche) o tym samym kształcie. Wyobraźmy sobie, że każdy z tych fragmentów jest „słowem”. Następnie musimy je zwektoryzować, czyli umieścić wszystkie wartości z jednego fragmentu w wektorze w określonej kolejności. Z każdego wektora x tworzone są następnie funkcje z z parametrami W i b, które są parametrami sieci wyuczonymi w procesie treningu. Dodatkowo dodawana jest informacja o kodowaniu pozycyjnym. Jest ona ważna, by zachować właściwą kolejność fragmentów. Potem wkracza warstwa Multi-Head Self-Attention i dzieje się magia - tak jak w oryginalnym Transformerze.
Jak widać na rysunku 3, cały model nie różni się zbytnio. Inaczej niż w oryginalnym transformerze musi wyglądać przygotowanie wejścia.
Aby użyć modelu Vision Transformer, możesz skorzystać z biblioteki timm:
import timm
import PIL
import torchvision.transforms as T

model_name = "vit_base_patch16_224"
model = timm.create_model(model_name, pretrained=True)

IMG_SIZE = (224, 224)
NORMALIZE_MEAN = (0.5, 0.5, 0.5)
NORMALIZE_STD = (0.5, 0.5, 0.5)
transforms = [
              T.Resize(IMG_SIZE),
              T.ToTensor(),
              T.Normalize(NORMALIZE_MEAN, NORMALIZE_STD),
              ]

img = PIL.Image.open('samochod.jpg')
img_tensor = transforms(img).unsqueeze(0)

output = model(img_tensor)
Model możesz zdefiniować bezpośrednio z biblioteki. To model już wstępnie wytrenowany, gotowy do użycia. Jako wejście podajesz obraz w postaci tensora - typowego typu danych używanego w widzeniu komputerowym. Jako wynik otrzymujesz klasę, do której należy obiekt, oraz wskaźnik pewności. Co ważne, nie musisz ręcznie wykonywać całego przetwarzania wstępnego wejścia - to dzieje się za ciebie 😊
Transformer a Vision Transformer
Zarówno Transformer, jak i Vision Transformer opierają się na tej samej idei - uwadze. Choć silnik modelu jest w obu przypadkach taki sam, wyraźna różnica widoczna jest na wejściu i wyjściu. Standardowym sposobem podawania tekstu do modelu jest tokenizacja. Obraz musi zostać przekształcony do podobnej postaci - pocięty na małe kawałki i uporządkowany. Wyjście również się różni, ponieważ cel zadania jest inny. Podając tekst, chcemy „odkrywać nieznane” - zobaczyć coś, czego jeszcze nie wiemy, natomiast przy przetwarzaniu obrazu chcemy raczej przeanalizować to, co jest na nim widoczne.
Większość powszechnie używanych modeli w NLP opiera się na Transformerze. Najczęściej wykorzystuje się je w botach jako formę komunikacji z klientem.
Vision Transformery z kolei zyskują popularność obok innych świetnych modeli. Można je stosować w klasyfikacji, detekcji i segmentacji obrazów, np. w analizie obrazów medycznych.
Używać czy nie?
Jak każdy model, transformery mają swoje wady i zalety. Wytrenowanie wartościowego transformera od zera jest niezwykle trudne - potrzeba ogromnych ilości danych i mocy obliczeniowej. Korzystanie z już istniejących daje jednak możliwość wykorzystania ich zdolności do „czytania kontekstu”. W wielu problemach kontekst jest raczej ważniejszy niż szczegóły.
Podsumowując - Attention is all you need! 😊
Autor: Maria Ferlin, Politechnika Gdańska
Źródła: