

Część 1: Streszczanie ekstrakcyjne w pigułce
 Autor: VoicelabVoiceLab
Na początek: czym jest streszczanie?
Według Wikipedii streszczanie tekstu „to proces obliczeniowego skracania zbioru danych w celu utworzenia podzbioru (streszczenia), który reprezentuje najważniejsze lub najistotniejsze informacje zawarte w oryginalnej treści”. Krótko mówiąc, chodzi o wydobycie wyłącznie kluczowych informacji.
Istnieją dwa główne podejścia: abstrakcyjne i ekstrakcyjne. W obu dobrze sprawdza się uczenie transferowe z użyciem transformerów.
W streszczaniu abstrakcyjnym stosuje się modele takie jak T5 czy BERT. Po odpowiednim treningu model potrafi generować streszczenia na podstawie podanego tekstu.
Z drugiej strony mamy podejście ekstrakcyjne: odnajdujemy najważniejsze fragmenty tekstu, a następnie łączymy je w streszczenie. W efekcie fragmenty streszczenia pochodzą z oryginalnego tekstu, podczas gdy w rozwiązaniu abstrakcyjnym model streszcza tekst nowymi sformułowaniami, zachowując jego sens.
Zalety i wady
Główną zaletą jest to, że czasem (zwłaszcza gdy nie mamy dobrego lub dużego zbioru danych) streszczanie ekstrakcyjne jest lepszym wyborem, ponieważ podejście abstrakcyjne może generować fałszywe informacje.
Jeśli chodzi o wady: streszczenia mogą być sztywne i powtarzalne, pozbawione językowej lekkości. Ponadto ogólna jakość w dużym stopniu zależy od jakości danych i modelu.
Zbiory danych
Pierwszą i najtrudniejszą rzeczą jest znalezienie zbioru danych najlepiej dopasowanego do twoich potrzeb. Przykładowe zbiory danych są dostępne w serwisie Papers with code.
Zaczynajmy.
- CNN/Daily Mail: przygotowane przez ludzi abstrakcyjne streszczenia w punktach, utworzone na podstawie artykułów z serwisów CNN i Daily Mail, posłużyły jako pytania (z jednym ukrytym podmiotem), a artykuły - jako odpowiadające im fragmenty, na podstawie których system ma uzupełnić lukę w pytaniu. Korpus zawiera 286 817 par treningowych, 13 368 par walidacyjnych i 11 487 par testowych.
- DebateSum: DebateSum składa się ze 187 328 dokumentów debat, argumentów (które można też traktować jako streszczenia abstrakcyjne lub zapytania), ekstrakcyjnych streszczeń na poziomie słów, cytatów oraz powiązanych metadanych uporządkowanych według tematu i roku. Dane są gotowe do analizy przez systemy NLP.
- WikiHow: WikiHow to zbiór danych zawierający ponad 230 000 par artykuł-streszczenie, wyodrębnionych i zbudowanych na podstawie internetowej bazy wiedzy tworzonej przez różnych autorów. Artykuły obejmują szeroki zakres tematów i reprezentują bardzo zróżnicowane style.
- SAMSum Corpus: nowy zbiór danych z abstrakcyjnymi streszczeniami dialogów.
Jaki model?
Oprócz danych potrzebujemy modelu uczenia maszynowego, którym je nakarmimy. Trenowanie transformera od zera jest bardzo czasochłonne i zasobożerne. Na szczęście mamy dostęp do wielu modeli, które wymagają jedynie dostrojenia (fine-tuningu), aby dopasować je do twoich potrzeb.
Ale czym właściwie jest transformer? Jeśli to pytanie właśnie przyszło ci do głowy, dowiedz się więcej z tego wpisu.
W streszczaniu ekstrakcyjnym najpopularniejszym modelem jest BERT: transformer opracowany przez Google, stworzony i opublikowany w 2018 roku. To dwukierunkowy transformer wstępnie wytrenowany z użyciem połączenia dwóch celów - maskowanego modelowania języka i przewidywania następnego zdania - na dużym korpusie obejmującym m.in. Wikipedię.
Oryginalny, anglojęzyczny BERT występuje w dwóch wersjach:
- BERT BASE: 12 enkoderów z 12 dwukierunkowymi głowicami mechanizmu samouwagi (self-attention),
- BERT LARGE: 24 enkodery z 16 dwukierunkowymi głowicami mechanizmu samouwagi.
Innym potężnym modelem jest T5, stworzony w 2020 roku również przez Google. To model typu enkoder-dekoder wstępnie wytrenowany na wielozadaniowej mieszance zadań nienadzorowanych i nadzorowanych, w której każde zadanie jest przekształcane do formatu tekst-tekst. Co ciekawe, T5 działa przez dodanie na początku danych wejściowych innego prefiksu dla każdego zadania, np. dla tłumaczenia: translate English to German: …, a dla streszczania: summarize: …..
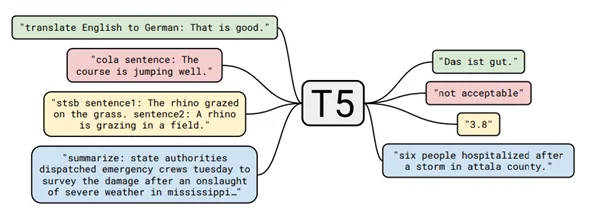
Jeśli chcesz dowiedzieć się więcej, zajrzyj do serwisu papers with code.
Skoro mamy już zbiór danych i model, zacznijmy trening. Ale skąd mam wiedzieć, czy moje streszczenia są trafne?
Metody oceny trafności
Metryki porównują streszczenie wygenerowane przez model ze streszczeniami referencyjnymi (wysokiej jakości, przygotowanymi przez ludzi). Najpopularniejszym zestawem metryk do oceny jakości wygenerowanego streszczenia jest ROUGE. Przyjrzyjmy mu się bliżej.
Referencja: The kitten is tiny and cute.
Streszczenie: Small kitten is cute.
ROUGE-N mierzy liczbę pasujących n-gramów między wygenerowanym tekstem a referencją. Dla ROUGE-1 precyzję (precision) obliczamy jako stosunek liczby tokenów streszczenia, które występują również w referencji: „kitten”, „is” i „cute”. Streszczenie ma długość 4, więc precyzja wynosi 3/4.
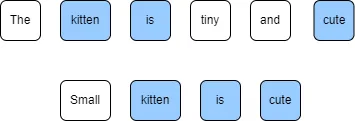
Pełność (recall) ROUGE-1 działa odwrotnie: to po prostu stosunek liczby unigramów referencji, które pojawiają się także w streszczeniu, do długości referencji - w naszym przypadku 3/6.
ROUGE-2 można obliczyć analogicznie.
W praktyce najczęściej używa się:
- ROUGE-1
- ROUGE-2
- ROUGE-L (opartej na najdłuższym wspólnym podciągu: LCS)
Niestety wynik ROUGE nie radzi sobie z różnymi słowami o tym samym znaczeniu, ponieważ mierzy dopasowania składniowe, a nie semantyczne.
Jak to zrobić?
W podejściu przedstawionym w artykule „Fine-tune BERT for Extractive Summarization”, przewidując streszczenie nowego dokumentu, najpierw używamy modelu, aby uzyskać wynik dla każdego zdania. Następnie szeregujemy zdania według wyników od najwyższego do najniższego i jako streszczenie wybieramy 3 najlepsze zdania.
W naszym przykładzie wybierzemy tylko jedno, najwyżej ocenione zdanie.
Przykładowy tekst (ze zbioru danych CNN/Daily Mail):
[1] Nieważne, że koty mają dziewięć żyć. [2] Bezpańska suczka w stanie Waszyngton zużyła co najmniej trzy własne: potrącił ją samochód, potem w źle pojętym akcie litości najwyraźniej uderzono ją młotkiem w głowę i zakopano na polu - a mimo to przeżyła.
[3] Tak twierdzi Uniwersytet Stanowy Waszyngtonu, gdzie suczka - przyjazny, biało-czarny mieszaniec typu bully, który otrzymał imię Theia - jest pod opieką Weterynaryjnego Szpitala Klinicznego.
[4] Cztery dni po rzekomej śmierci psu udało się dowlec do pobliskiej farmy - brudnemu i wychudzonemu - gdzie znalazł go pracownik, który zawiózł go do weterynarza.
Powyższe dane mają więc 4 zdania. Jeśli podamy je modelowi, wynik może wyglądać tak:
[0.1; 0.5; 0.2; 0.2]
Jak widać, najwyższy wynik ma drugie zdanie i to ono trafi do streszczenia.
Ten przykład został uproszczony, aby był zrozumiały dla osób bez doświadczenia. W artykule autorzy budują kilka warstw przeznaczonych do streszczania, umieszczonych na wyjściach BERT, aby uchwycić cechy na poziomie całego dokumentu potrzebne do wyodrębniania streszczeń. Te warstwy są dostrajane wspólnie z BERT. Dla ciekawskich kod jest dostępny tutaj.
Podsumowanie
Ten artykuł był wprowadzeniem do zadania streszczania ekstrakcyjnego. Mam nadzieję, że była to ciekawa przygoda 🙂 Jeśli chcesz dowiedzieć się więcej, przeczytaj Część 2: Streszczanie abstrakcyjne.
Źródła
https://en.wikipedia.org/wiki/Automatic_summarization
https://en.wikipedia.org/wiki/BERT_(language_model)
https://medium.com/nlplanet/two-minutes-nlp-learn-the-rouge-metric-by-examples-f179cc285499
Obrazy
Bert: https://muppety.fandom.com/pl/wiki/Bert
Kocięta: https://www.publicdomainpictures.net/en/view-image.php?image=167326&picture=cat-on-the-white
Autor: Patrycja Biryło