

Wyjaśnialna sztuczna inteligencja (XAI) w analizie sentymentu
 Autor: VoicelabVoiceLab
Sposób na zrozumienie, co próbuje nam przekazać model NLP.
Problem
Analiza sentymentu to w gruncie rzeczy rozpoznawanie tonu emocjonalnego wypowiedzi - w naszym przypadku rozwiązanie AI mówi nam, czy dana wypowiedź jest negatywna, neutralna czy pozytywna:
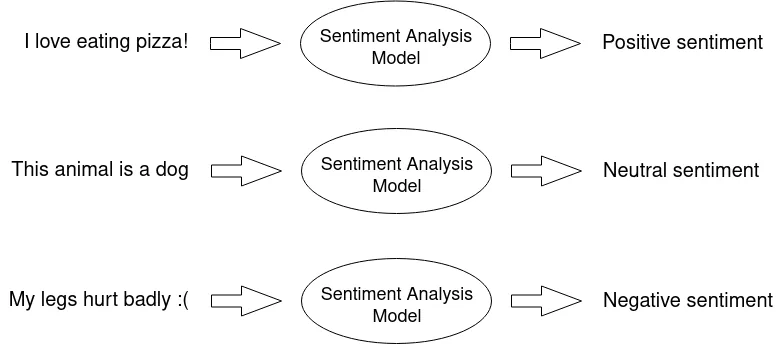
Nasze podejście, wykorzystane dane, ich przetwarzanie oraz architekturę modelu opisaliśmy już szczegółowo w poprzednim artykule. W skrócie: korzystamy z rozwiązania opartego na HerBERT, które trenujemy na oznaczonych danych z Twittera.
Postanowiliśmy sięgnąć po XAI (wyjaśnialną sztuczną inteligencję), aby lepiej zrozumieć, jak nasz model podejmuje decyzje. Chcieliśmy sprawdzić, które cechy mają największy wpływ na ostateczny werdykt i czy da się wskazać obszary do poprawy.
Wyjaśnialna sztuczna inteligencja - co i dlaczego?
Czym jest XAI?
XAI (eXplainable AI, wyjaśnialna sztuczna inteligencja) to koncepcja AI, która pozwala nam, ludziom, lepiej rozumieć przewidywane wyniki. Można powiedzieć, że otwieramy czarną skrzynkę.
Większość z nas słyszała określenie „czarna skrzynka” w odniesieniu do modeli głębokiego uczenia. Definiuje się ją jako złożony system lub urządzenie, którego wewnętrzne działanie jest ukryte lub trudne do zrozumienia. Określenie to wzięło się stąd, że zazwyczaj nawet twórcy modelu nie potrafią powiedzieć, dlaczego AI doszła do konkretnego wniosku.
Dlaczego XAI?
Z jednej strony można powiedzieć, że budowanie głębokich, wielowarstwowych modeli bez konieczności rozumienia całego procesu decyzyjnego jest korzystne - i nie będzie to nieprawda. Zdejmuje to z nas zmartwienia i czyni proces dość wygodnym. Skąd jednak możemy mieć pewność, że nasza predykcja opiera się na właściwych przesłankach?
Wiarygodność
Nawet jeśli osiągamy wysoką dokładność na zbiorze testowym, nie musi ona odpowiadać dokładności wnioskowania w rzeczywistych warunkach. Wyniki będą też obciążone, jeśli obciążony jest zbiór danych, a wysokie wyniki mogą nas zwieść i przekonać, że system działa bez zarzutu. Odporność modeli jest szczególnie ważna w takich dziedzinach jak medycyna, finanse czy prawo, gdzie zrozumienie uzasadnienia decyzji jest kluczowe, ponieważ jej konsekwencje mogą być fatalne.
Próba głębszego zajrzenia do wnętrza wspomnianej „czarnej skrzynki” może przynieść ogromne korzyści. Brak możliwości pełnego wyjaśnienia decyzji podejmowanych przez AI od lat stanowi spory problem.
Zaufanie
Istnieje zjawisko, które w skrócie można określić jako awersję do algorytmów (algorithm aversion) - sytuację, w której ludzie nie ufają decyzjom modeli algorytmicznych, nawet wiedząc, że radzą sobie one lepiej niż ludzie.
Ludzie boją się tego, czego nie rozumieją, a tak zwykle jest w przypadku modeli typu czarna skrzynka. Brak zrozumienia, dlaczego model AI zdecydował tak, a nie inaczej, rodzi niepewność i wątpliwości. To z kolei prowadzi do braku zaufania i odrzucania decyzji, które mogłyby być lepsze od naszego osądu.
Logiczne jest założenie, że ludzie chętniej słuchaliby AI, gdyby lepiej rozumieli proces podejmowania decyzji.
Jak to działa?
Możemy wyróżnić dwa główne typy podejść do wyjaśniania predykcji modelu:
- zbudowanie prostszego, przejrzystego modelu
- użycie modelu typu czarna skrzynka i wyjaśnienie go po fakcie
Przejrzyste modele ML, takie jak prostsze drzewo decyzyjne, modele bayesowskie czy regresja liniowa, choć łatwe w interpretacji, często okazują się słabsze od swoich odpowiedników typu czarna skrzynka. Ponieważ zależy nam na jak najlepszej skuteczności, potrzebujemy dodatkowej warstwy post-hoc nad naszym rozwiązaniem.
Podejście post-hoc
Post-hoc, czyli po fakcie, oznacza w naszym przypadku wyjaśnienie tworzone po wykonaniu predykcji (lub serii predykcji).
Wyjaśnienia mogą być niezależne od modelu (Model Agnostic - działają z dowolnym modelem) albo specyficzne dla modelu (Model Specific). Najbardziej interesuje nas podejście niezależne od modelu, ponieważ pozwala wyjaśnić dowolny model bez względu na jego architekturę.
Chcemy też skupić się na idei ważności cech (Feature Importance) - czyli zmierzyć, jak pojedyncza cecha (zmienna wejściowa) przyczynia się do przewidywanego wyniku.
Takie podejście bardzo dobrze pasuje do dziedziny przetwarzania języka naturalnego (NLP).
XAI w NLP
W problemach klasyfikacji w NLP często analizujemy sekwencję słów podaną na wejściu, a na wyjściu otrzymujemy prawdopodobieństwo przynależności do każdej z klas.
Wyjaśniając pojedynczą predykcję, chcemy w gruncie rzeczy zmierzyć, jak każdy element wejścia wpływa na prawdopodobieństwo każdej z klas. To dość proste. Trudność polega na tym, jak to zrobić.
W ostatnich latach powstało wiele algorytmów. Wybraliśmy dwa narzędzia wyjaśniające (explainers) ze względu na ich prostotę i zrozumiałość: LIME i SHAP. Rozwiązania, z których korzystamy, są dość intuicyjne i łatwe do zrozumienia.
LIME - Local Interpretable Model-Agnostic Explanations
LIME to jedno z pierwszych podejść opartych na perturbacjach, służących do wyjaśniania pojedynczej predykcji. Jak czytamy na stronie projektu na GitHubie:
Lime potrafi wyjaśnić dowolny klasyfikator typu czarna skrzynka z dwiema lub większą liczbą klas. Wymagamy jedynie, aby klasyfikator implementował funkcję, która przyjmuje surowy tekst lub tablicę NumPy i zwraca prawdopodobieństwo dla każdej klasy.
W efekcie LIME można zastosować do dowolnego modelu, który przyjmuje surowy tekst lub tablicę NumPy i zwraca na wyjściu prawdopodobieństwo dla każdej klasy.
Co jednak dokładnie robi?
Główna idea polega na tym, że łatwiej jest przybliżyć cały model prostszym modelem lokalnym. Jak to osiągnąć?
Wykonujemy perturbację sekwencji wejściowej (np. ukrywamy jedno słowo zdania, oznaczając je tokenem MASK) i sprawdzamy, jak zmieniają się predykcje. Następnie wyniki dla zaburzonych wejść ważone są ich podobieństwem do wyjaśnianego przykładu.
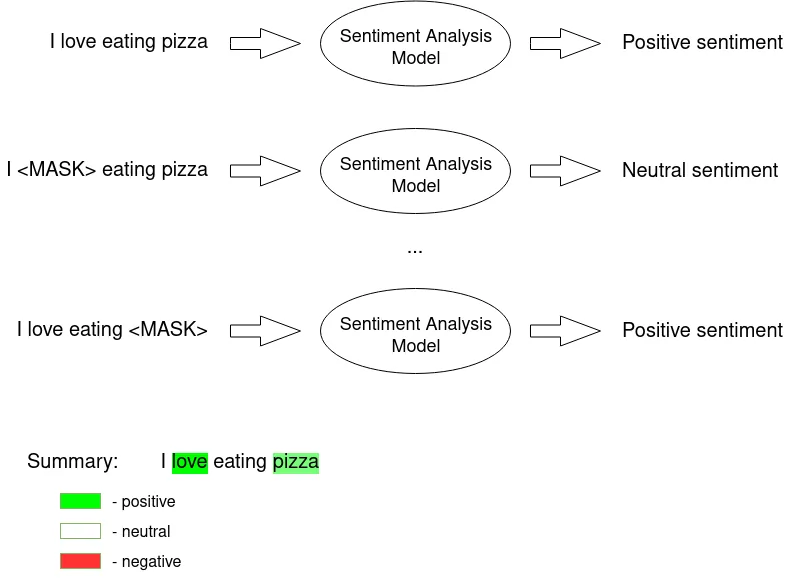
Intuicyjnie wyjaśnienie jest lokalnym liniowym przybliżeniem zachowania modelu. Choć model może być globalnie bardzo złożony, łatwiej jest go przybliżyć w otoczeniu konkretnego przykładu. Traktując model jak czarną skrzynkę, zaburzamy próbkę, którą chcemy wyjaśnić, i uczymy wokół niej rzadki model liniowy, który stanowi wyjaśnienie. Rysunek poniżej ilustruje intuicję stojącą za tą procedurą. Funkcja decyzyjna modelu jest przedstawiona jako niebiesko-różowe tło i jest wyraźnie nieliniowa. Jaskrawoczerwony krzyżyk to wyjaśniany przykład (nazwijmy go X). Losujemy przykłady wokół X i ważymy je według ich bliskości do X (waga jest tu oznaczona rozmiarem). Następnie uczymy model liniowy (linia przerywana), który dobrze przybliża model w otoczeniu X, ale niekoniecznie globalnie.
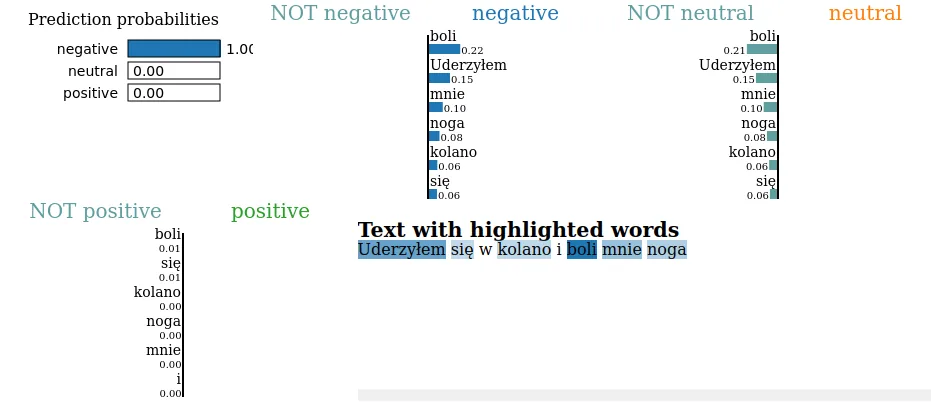
Ponieważ wejście ma postać zrozumiałych słów, możemy łatwo zinterpretować otrzymane wyniki. Na wyjściu otrzymujemy listę wszystkich cech i ich wkład w każdą z klas.
Przykładowa wizualizacja:
SHAP - SHapley Additive exPlanations
Ten algorytm jest nieco podobny do LIME, ponieważ również zaburza wejście, aby utworzyć wyjaśnienie. Robi to jednak w trochę inny sposób.
Jeśli chcesz zrozumieć wszystkie szczegóły metodologii SHAP, tutaj znajdziesz świetny artykuł, który omawia ten temat w naprawdę przystępny sposób.
W skrócie: SHAP oblicza wkład, jaki każda cecha wnosi do predykcji modelu. Wyznaczanie tego wkładu opiera się na założeniu, że aby określić ważność pojedynczej cechy, należy rozważyć wszystkie możliwe kombinacje cech (w matematyce: zbiór potęgowy). SHAP przybliża więc wszystkie możliwe modele na podstawie dostarczonego zbioru danych (tj. wejścia, które podaliśmy w danym wyjaśnieniu). Mając wszystkie możliwe kombinacje, uwzględnia się wszystkie wkłady krańcowe każdej cechy.
Wkład krańcowy (marginal contribution) danej cechy dotyczy sytuacji, w której mamy dwa niemal identyczne scenariusze, różniące się jedynie obecnością (lub brakiem) interesującej nas cechy.
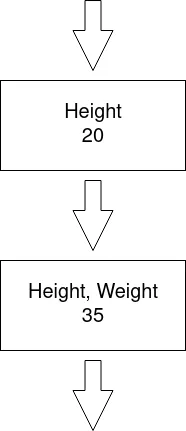
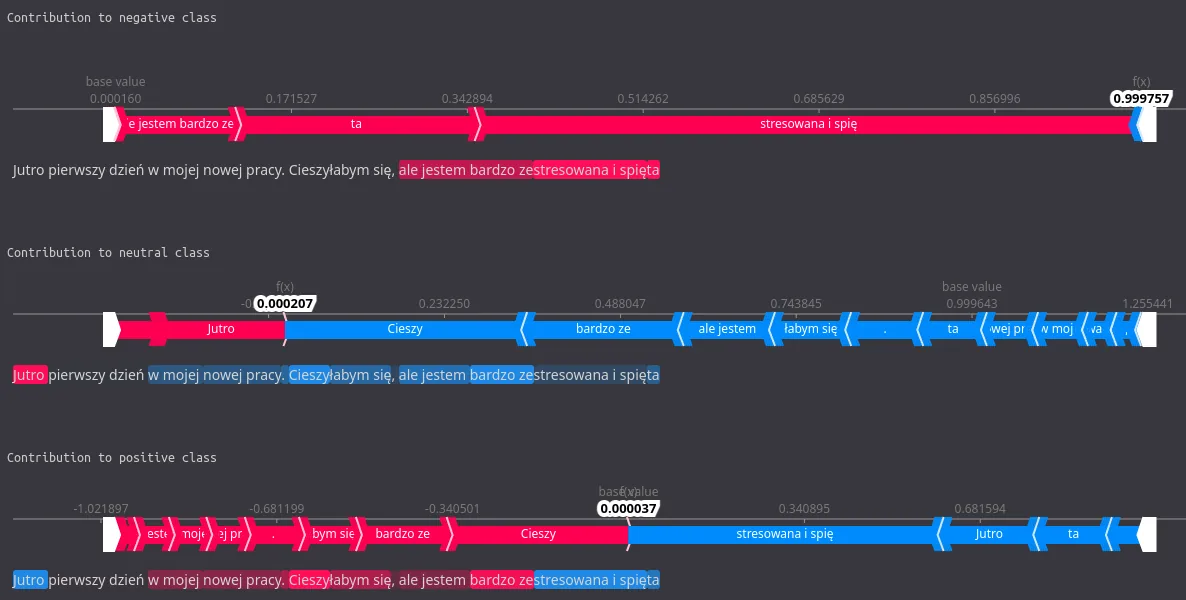
Wszystkie wkłady krańcowe są następnie agregowane za pomocą średniej ważonej, a wynik reprezentuje wkład danej cechy w daną klasę. Podsumowanie można następnie zwizualizować, np. za pomocą wykresu sił (force plot), takiego jak poniższy:
LIME i SHAP w analizie sentymentu
Skoro algorytmy zostały wybrane i objaśnione, możemy sprawdzić, jak radzą sobie w praktyce - w naszym przypadku podczas analizy tonu emocjonalnego polskich wypowiedzi.
Przypomnijmy: korzystamy z modelu opartego na HerBERT (polskim BERT) i wyróżniliśmy trzy klasy - negatywną, neutralną i pozytywną.
Przykładowa wypowiedź do analizy:
Jutro pierwszy dzień w mojej nowej pracy. Cieszyłabym się, ale jestem bardzo zestresowana i spięta
Rzeczywisty sentyment: negatywny
Przewidywany sentyment: negatywny
Jak widać, model poprawnie przewidział negatywny sentyment podanego zdania, choć przykład jest nieco podchwytliwy. Przejdźmy teraz do procesu wyjaśniania i sprawdźmy, które cechy wpłynęły na tę decyzję.
LIME
Najpierw sprawdźmy, jak radzi sobie LIME. Wczytujemy model z punktu kontrolnego (checkpointu):
device = 'cpu'
model = HerbertSentiment.load_from_checkpoint(model_path,
                                                test_dataloader = None,
                                                output_size = 3,
                                                hidden_dim = 1024,
                                                n_layers = 2,
                                                bidirectional = True,
                                                dropout = 0.5,
                                                herbert_training = True,
                                                lr = 1e-5,
                                                training_step_size = 2,
                                                gamma = 0.9,
                                                device = device,
                                                logger = None,
                                                explaining = True)
Następnie konfigurujemy LIME:
tokenizer_path = "allegro/herbert-base-cased"
tokenizer = AutoTokenizer.from_pretrained(tokenizer_path)
target_names = ['negative', 'neutral', 'positive']

explainer = LimeTextExplainer(class_names=['negative', 'neutral', 'positive'])
Na koniec tworzymy wyjaśnienie.
input = "Jutro pierwszy dzień w mojej nowej pracy. Cieszyłabym się, ale jestem bardzo zestresowana i spięta"

explanation = explainer.explain_instance(input, model.forward, num_features=6, labels=[0,1,2])
…i wypisujemy wyniki:
print ('Explanation for class %s' % target_names[0])
print ('\n'.join(map(str, exp.as_list(label=0))))
print()
print ('Explanation for class %s' % target_names[1])
print ('\n'.join(map(str, exp.as_list(label=1))))
print()
print ('Explanation for class %s' % target_names[2])
print ('\n'.join(map(str, exp.as_list(label=2))))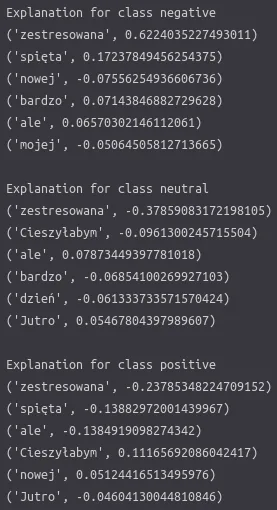
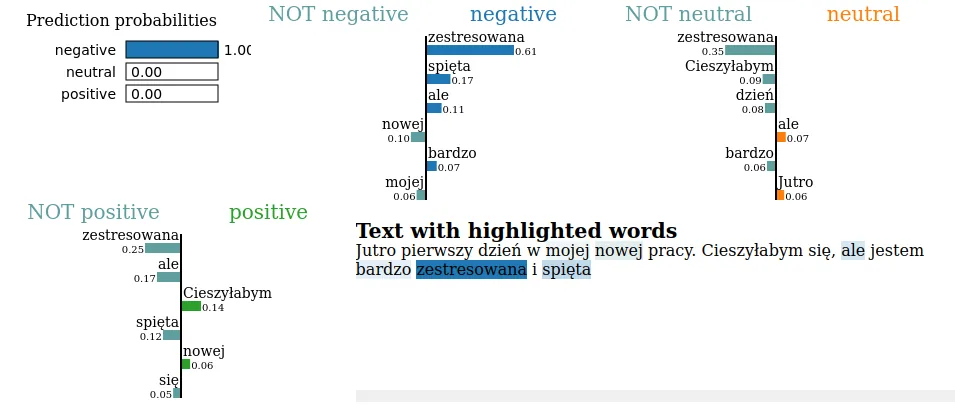
Te nieuporządkowane liczby na obrazie określają, jak dane słowo wpłynęło na każdą z klas. Jeśli liczba jest >0, zwiększyła szansę na daną klasę. Jeśli natomiast jest <0, ją zmniejszyła.
explanation.show_in_notebook()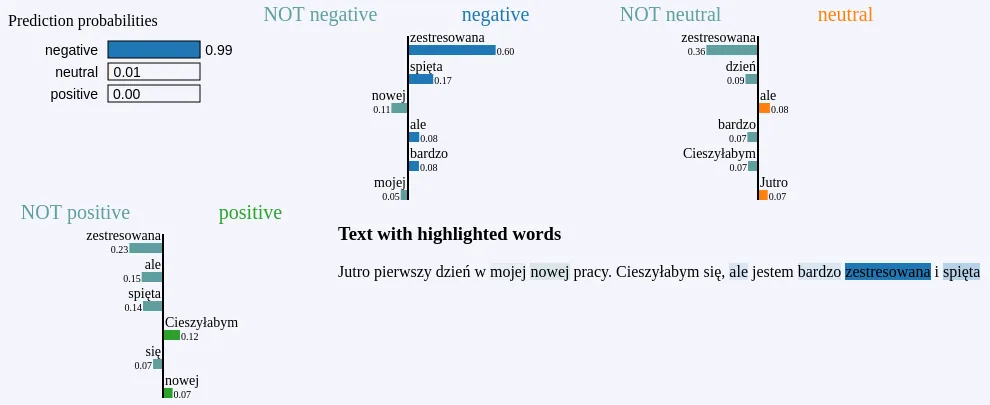
W przedstawionej powyżej dedykowanej wizualizacji LIME wyniki nieco łatwiej zinterpretować. Szybko widać, które tokeny miały największy wpływ na poszczególne klasy. Na przykład słowo „zestresowana” znacząco wpłynęło na wszystkie kategorie - mocno zwiększyło szansę na klasę negative i obniżyło szanse zarówno klasy neutral, jak i positive.
Jak widać, może to dostarczyć przydatnych wskazówek.
Porównajmy teraz to wszystko z SHAP…
SHAP
Model wczytujemy w ten sam sposób:
device = 'cpu'
model = HerbertSentiment.load_from_checkpoint(model_path,
                                                test_dataloader = None,
                                                output_size = 3,
                                                hidden_dim = 1024,
                                                n_layers = 2,
                                                bidirectional = True,
                                                dropout = 0.5,
                                                herbert_training = True,
                                                lr = 1e-5,
                                                training_step_size = 2,
                                                gamma = 0.9,
                                                device = device,
                                                logger = None,
                                                explaining = True)
Następnie konfigurujemy SHAP:
tokenizer_path = "allegro/herbert-base-cased"
tokenizer = AutoTokenizer.from_pretrained(tokenizer_path)
target_names = ['negative', 'neutral', 'positive']

explainer = shap.Explainer(model, tokenizer)
Przygotowujemy metody do wizualizacji wyników:
def print_explanation(shap_values):
    values = shap_values.values
    data = shap_values.data
    for word, shap_value in zip(data[0], values[0]):
        print(word, shap_value, '---', target_names[np.argmax(shap_value)])

def print_contribution(shap_values):
    print('\n')
    print("Contribution to negative class")
    shap.plots.text(shap_values[0, :, 0])
    print('\n')
    print("Contribution to neutral class")
    shap.plots.text(shap_values[0, :, 1])
    print('\n')
    print("Contribution to positive class")
    shap.plots.text(shap_values[0, :, 2])
Na koniec tworzymy wyjaśnienie…
input_to_explain = ["Jutro pierwszy dzień w mojej nowej pracy. Cieszyłabym się, ale jestem bardzo zestresowana i spięta"]

shap_values = explainer(input_to_explain)
…i wypisujemy wyniki:
print_explanation(shap_values)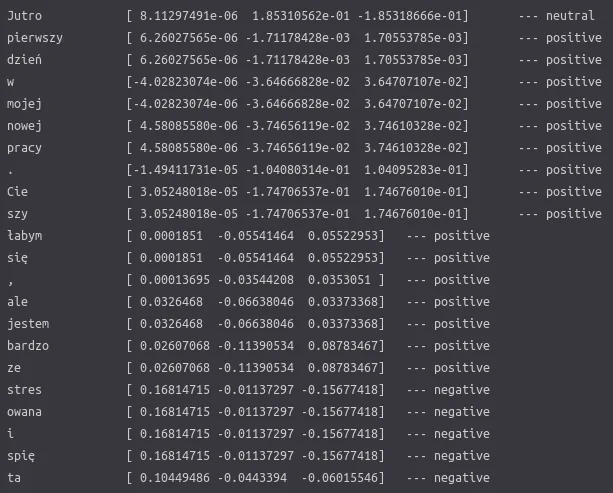
Widzimy liczby pokazujące, jak tokeny zdania przyczyniają się do każdej z klas - podobnie jak w LIME. Dodatkowo po prawej stronie widoczny jest dominujący sentyment.
Można zauważyć, że niektóre słowa są dzielone i analizowane w dziwny sposób, ponieważ SHAP w procesie wyjaśniania korzysta z tokenizera HerBERT. Tokenizer analizuje sekwencję wejściową i szuka każdego z tokenów (słów) w swoim słowniku. Jeśli danego słowa w nim nie ma, dzieli je na części, które się w nim znajdują. Np. „Uwielbiam” zostanie podzielone na „Uwielbi” i „am”. Ten proces pomaga ignorować ewentualny szum fleksyjny wynikający z reguł polskiej gramatyki (męska forma słowa różni się od żeńskiej formy tego samego słowa).
print_contribution(shap_values)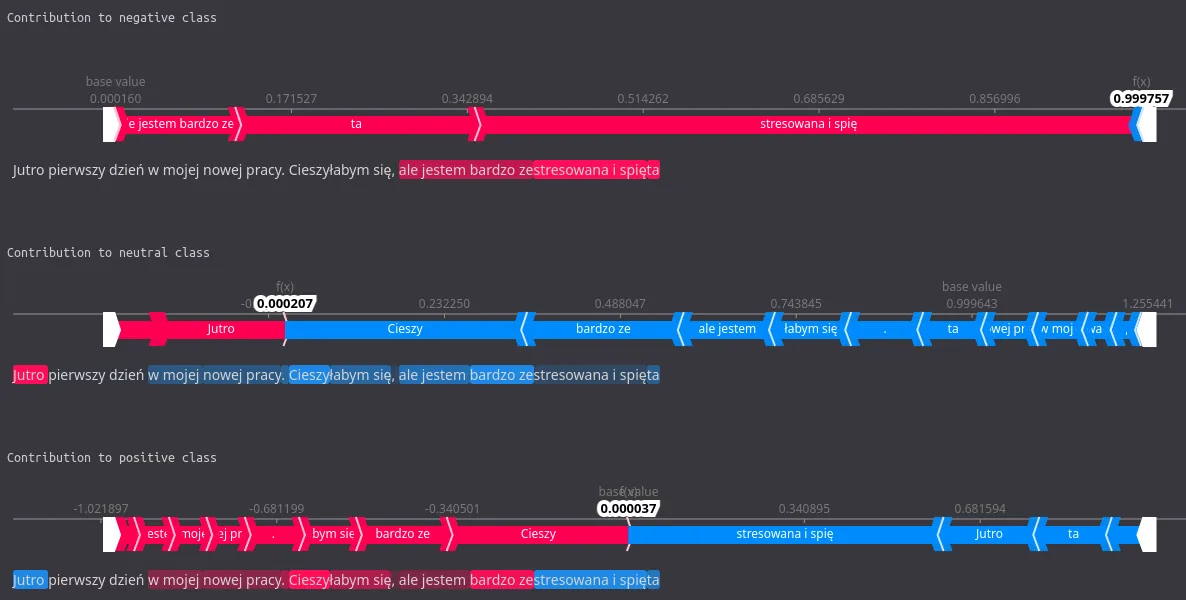
W tej bardziej kolorowej wizualizacji przedstawiono te same dane, ale w bardziej przystępny sposób. Dla każdej z klas widać wykres sił wraz ze wszystkimi słowami, które mają na nią wpływ. Słowa oznaczone kolorem czerwonym zwiększyły prawdopodobieństwo danej klasy, a te oznaczone niebieskim - je obniżyły. Łatwo dostrzec, które tokeny miały największy wpływ, zarówno na wykresie sił, jak i w wyróżnieniach w zdaniu pod wykresem.
Na przykład widzimy, że słowa (lub ich części) „zestresowana i spięta” dość mocno wpływają na sentyment negatywny, a sentyment pozytywny znacząco obniżają.
Właściwa interpretacja takich wizualizacji pozwala dobrze zrozumieć, jak „myśli” nasz model i co najbardziej wpływa na wynik.
Podsumowanie
Jak widać, XAI daje nam ciekawy i wartościowy wgląd w działanie naszego modelu. Proces wyjaśniania nie jest tak złożony, jak mogłoby się wydawać, a biorąc pod uwagę korzyści, jest wart wysiłku. Właściwa interpretacja wyników, w tym zrozumiałych wizualizacji, pozwala dobrze zrozumieć, jak „myśli” nasz model i co najbardziej wpływa na predykcje.
Jeśli twój problem uczenia maszynowego dotyczy jednej z dziedzin, w których kluczowe jest zbudowanie zaufania do algorytmu i w których awersja do algorytmów może przysporzyć ci kłopotów, z pomocą przychodzi wyjaśnialna sztuczna inteligencja. Pamiętaj o tym, gdy następnym razem zechcesz zajrzeć głębiej w swój algorytm.
Autorzy: Filip Żarnecki, Michał Laskowski