

COVID-19 - źródło gorącej dyskusji
 Autor: VoicelabVoiceLab
Motywacja
Bez wątpienia COVID-19 wywarł ogromny wpływ na dzisiejszy świat. Zmienił niemal wszystkie aspekty codziennego życia i stał się nieodłączną częścią debaty publicznej. Z powodu licznych obostrzeń związanych z COVID-19 większość rozmów przeniosła się do mediów społecznościowych, zwłaszcza na Twittera, jedną z największych platform społecznościowych na świecie. Ponieważ publikowane tam opinie silnie wpływają na stosunek społeczeństwa do COVID-19, ważne jest zrozumienie, jak użytkownicy Twittera postrzegają globalną pandemię. Niestety liczba tweetów publikowanych w internecie jest ogromna, więc analiza wykonywana przez ludzi jest niemożliwa. Na szczęście w tym celu można wykorzystać jedno z podstawowych zadań przetwarzania języka naturalnego - analizę sentymentu - która klasyfikuje dane tekstowe np. do 3 kategorii (negatywny, neutralny, pozytywny).
Dziś chcemy podzielić się kilkoma kluczowymi wnioskami z tego, jak przeprowadziliśmy taką analizę sentymentu na pobranych polskich tweetach dotyczących COVID-19.
Scraping Twittera
Na początku musieliśmy pobrać (zescrapować) z Twittera odpowiednie tweety.
Ponieważ szczególnie interesowała nas analiza sytuacji pandemicznej w Polsce, pobraliśmy tweety, które:
- zostały napisane po polsku,
- zostały opublikowane od początku pandemii (marzec 2020) do początku wakacji (lipiec 2021),
- zawierają co najmniej jedno słowo z empirycznie utworzonej listy słów kluczowych związanych z COVID-19 (takich jak „covid” czy „szczepienie” itp.)
Dzięki takiemu podejściu udało nam się pobrać ponad 2 miliony tweetów wraz z ich treścią i różnymi metadanymi, takimi jak:
- liczba polubień danego tweeta,
- liczba odpowiedzi pod danym tweetem,
- liczba udostępnień danego tweeta itp.
Treningowy zbiór danych
Do wytrenowania modelu potrzebowaliśmy jednak również danych z wcześniej oznaczonym sentymentem (negatywny, neutralny, pozytywny).
Niestety obecnie nie istnieje publicznie dostępny zbiór danych zawierający polskie tweety o COVID-19. Dlatego musieliśmy rozszerzyć publicznie dostępny zbiór danych z Twittera z repozytorium CLARIN.SI o 100 samodzielnie oznaczonych tweetów o COVID-19, aby wytrenować model na próbce tekstów z tej dziedziny.
Wstępne przetwarzanie danych
Przed rozpoczęciem treningu przeprowadziliśmy wstępne przetwarzanie danych. W naszym przypadku było to szczególnie ważne, ponieważ dane z Twittera zawierają dużo „zaszumionego” tekstu, takiego jak zarezerwowane słowa Twittera (np. RT - dla retweetów) i oznaczenia użytkowników. Za pomocą biblioteki tweet-preprocessor usunęliśmy wszystkie te zbędne fragmenty tekstu, które mogłyby stać się szumem dla modelu.
Ponadto zastąpiliśmy linki specjalnym tokenem $URL$, tak aby model postrzegał każdy link jako ten sam. Było to szczególnie istotne, ponieważ w późniejszej fazie zauważyliśmy, że informacja o obecności linku jest cenna dla predykcji modelu.
Na koniec etapu wstępnego przetwarzania postanowiliśmy zastąpić emotikony ich rzeczywistym znaczeniem (np. „:)” zamieniliśmy na „happy”, a „:(” na „sad” itp.).
Architektura modelu
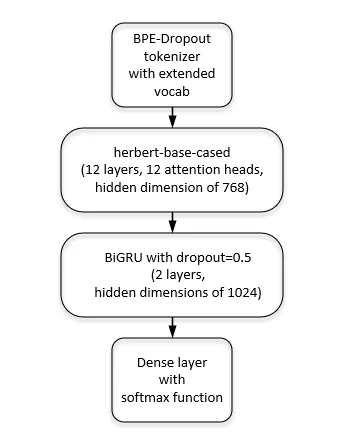
Po oczyszczeniu danych mogliśmy zbudować model. Postanowiliśmy oprzeć go na HerBERT (polskiej wersji BERT), ponieważ osiąga on najlepsze obecnie wyniki w klasyfikacji tekstu. Dodaliśmy po nim dwie warstwy dwukierunkowej jednostki rekurencyjnej z bramkami (GRU) oraz warstwę w pełni połączoną.
Tokenizer BPE-Dropout z HerBERT (który przed przekazaniem danych wejściowych do HerBERT zamienia tekst na tokeny) rozszerzyliśmy o dodatkowe tokeny związane z COVID-19, tak aby rozpoznawał (i nie rozdzielał) podstawowych słów dotyczących koronawirusa.
Skuteczność modelu
| Metryka | Wynik |
|---|---|
| F1-Score | 70.51% |
| Accuracy | 72.14% |
| Precision | 70.60% |
| Recall | 70.44% |
Model osiąga stosunkowo dobre wyniki, mimo że dane z Twittera są często uważane za niejednoznaczne pod względem samej etykiety sentymentu oraz za ironiczne.
Analiza danych
Za pomocą wytrenowanego modelu przewidzieliśmy sentyment wcześniej pobranych tweetów o COVID-19. Pozwoliło nam to przeprowadzić bardziej szczegółową analizę, opartą nie tylko na zebranych metadanych (np. polubieniach, odpowiedziach, retweetach), ale także na przewidzianym sentymencie.
Po zwizualizowaniu tygodniowej liczby tweetów dla każdego sentymentu w czasie widać kilka negatywnych „szczytów”
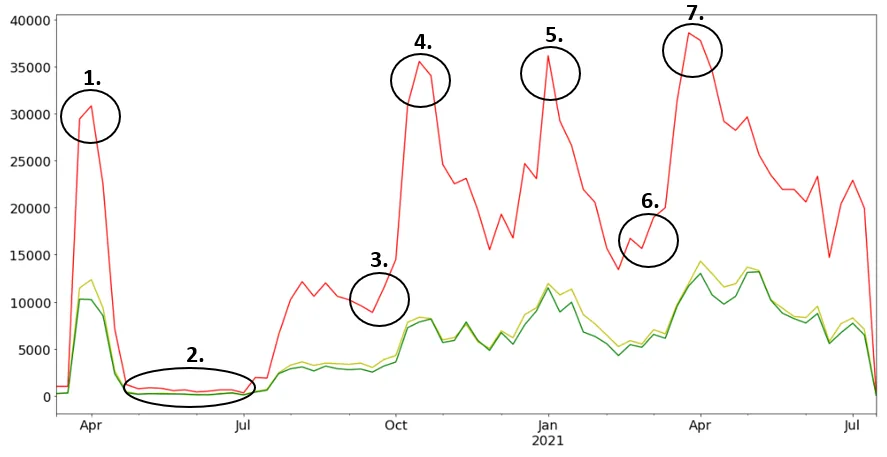
W większości przypadków są one ściśle skorelowane z ważnymi wydarzeniami i decyzjami w Polsce, takimi jak:
- przełożenie wyborów prezydenckich
- kampania prezydencka
- początek drugiej fali COVID-19
- powrót twardego lockdownu
- początek szczepień w Polsce
- początek trzeciej fali COVID-19
- dzienny rekord zakażeń (ponad 35 000 nowych przypadków)
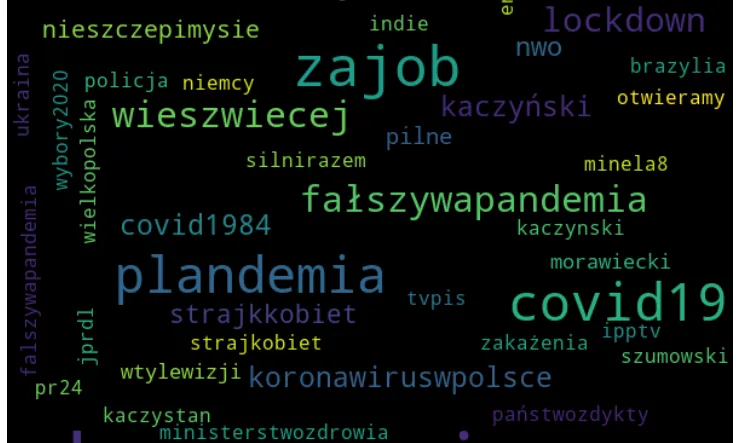
Gdy postanowiliśmy dokładniej przyjrzeć się treści negatywnych tweetów, okazało się, że najczęściej używane negatywne wyrażenia to:
Bez wątpienia są one nieco przesunięte w stronę słów kluczowych, na podstawie których pobieraliśmy tweety, ale ogólnie dobrze oddają tematy poruszane w negatywnych tweetach, czyli politykę i popularne tagi używane w działaniach związanych z fake newsami.
Ponadto chcieliśmy sprawdzić, które konto jest najczęściej oznaczane w tych negatywnych tweetach. Okazało się, że:
- najczęściej obwiniani są politycy za ich decyzje dotyczące pandemii
- konta najpopularniejszych programów telewizyjnych w Polsce stanowią dużą część dyskusji o COVID-19
Na koniec postanowiliśmy przeanalizować konta na Twitterze, które swoimi negatywnymi tweetami najbardziej wpływają na społeczeństwo (czyli te, które zdobywają relatywnie najwięcej polubień, odpowiedzi i retweetów).
Nic dziwnego, że na szczycie listy znajdują się politycy polskiej opozycji.
Podsumowanie
Podsumowując, jak wszyscy widzimy, analiza sentymentu połączona z analizą danych może dać nam ciekawy wgląd w charakterystykę badanej społeczności. Przynosi wiele korzyści i pozwala skutecznie wykorzystywać ogromne ilości danych tekstowych.
Autorzy: Michał Laskowski, Filip Żarnecki