

Pseudoetykietowanie w rozpoznawaniu mowy
 Autor: VoicelabVoiceLab
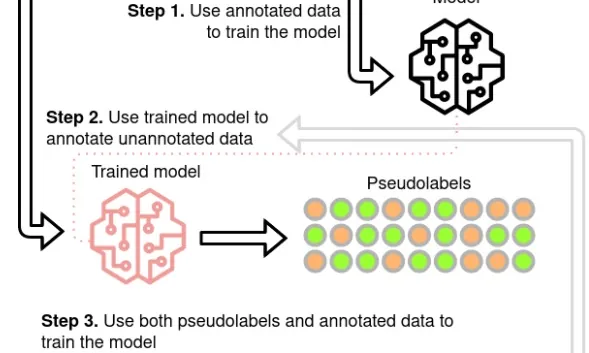
Dane są kluczowym składnikiem uczenia maszynowego, które opiera się na uczeniu się z nich. Uczenie głębokie (Deep Learning) jest jeszcze bardziej „głodne” danych, ponieważ duże modele muszą dobrze generalizować i unikać nadmiernego dopasowania (overfittingu) do danych treningowych. W większości problemów uczenia maszynowego, takich jak rozpoznawanie mowy, pozyskanie dużej ilości oetykietowanych danych jest bardzo kosztowne i czasochłonne. Pisaliśmy o tym w poprzednim wpisie o trendzie uczenia samonadzorowanego w rozpoznawaniu mowy (link). Paradygmat samonadzorowany jest dość nowy, ale to bardzo obiecująca metoda stosowana w rozpoznawaniu mowy (link). Inną metodą, stosowaną jeszcze przed erą uczenia głębokiego, jest pseudoetykietowanie (Pseudo Labelling) (link, link, link, link). To paradygmat uczenia częściowo nadzorowanego (Semi-Supervised), w którym model uczy się na etykietach wygenerowanych przez siebie samego.
Standardowa procedura polega na przewidzeniu etykiet dla nieoetykietowanych danych i odfiltrowaniu tych, których prawdopodobieństwo predykcji jest dość niskie. Powinny pozostać tylko przykłady, które w większości przypadków mają poprawne etykiety. To, jak dobrze działa ta technika, w dużym stopniu zależy od jakości modelu i od tego, na ile wiarygodne są prawdopodobieństwa. W zadaniach, w których wynikiem nie jest pojedyncza etykieta, lecz sekwencja - jak w rozpoznawaniu mowy - pojawia się dodatkowy problem: co zrobić z przykładami, w których część jest rozpoznana z dość dużą pewnością, a część ze znacznie gorszym prawdopodobieństwem. Przykładem może być jednokanałowa rozmowa telefoniczna agenta z klientem, w której mowa klienta ma często znacznie gorszą jakość. Warto zauważyć, że głos agenta ma dużo lepszą jakość, ale to głos klienta wnosi znacznie więcej zmienności mówców i domen. Aby poprawić jakość filtrowania, pseudoetykiety można sprawdzać pod kątem błędów charakterystycznych dla danego modelu (link). W trakcie tego procesu trudne przykłady są odfiltrowywane. Podobnie jak w treningu nadzorowanym, aby dane były bardziej użyteczne, model trzeba zaburzać regularyzacjami, takimi jak dropout, albo augmentować dane szumem lub SpecAugment (link, link), żeby wydobyć z nich więcej.
Metoda pseudoetykietowania (źródło)
Po ulepszeniu modelu w układzie z pseudoetykietami nasuwa się pytanie, czy model, który uczył się na nieoetykietowanych danych, mógłby wygenerować dla nich lepsze pseudoetykiety niż model w pełni nadzorowany. Zbadano to w (link) jako iteracyjne pseudoetykietowanie (Iterative Pseudo Labelling) oraz w (link) jako Noisy Student Training. Obie prace wskazują, że kluczem do dobrych wyników są augmentacja danych, dekodowanie beam search z zewnętrznym modelem języka (LM) oraz równowaga między zbiorem oetykietowanym i nieoetykietowanym. (link) stosuje też mechanizm filtrowania, co prawdopodobnie prowadzi do lepszych wyników. W obu podejściach najbardziej problematycznymi elementami są dekodowanie beam search i zewnętrzny LM. Beam search - bo jest kosztowny obliczeniowo, co ogranicza liczbę iteracji. Zewnętrzny LM - bo wprowadza obciążenie (bias) do modelu akustycznego (AM) (link). (link) proponuje IPL bez modelu języka (Language-Model-Free IPL, slimIPL), które rezygnuje z beam search i LM na rzecz najbardziej prawdopodobnych wyjść AM w połączeniu z dynamiczną pamięcią podręczną (cache). Dynamiczny cache sprawia, że część nieoetykietowanych przykładów jest ponownie przetwarzana w krótkim czasie z tymi samymi pseudoetykietami. Wykazano, że znacznie zwiększa to stabilność treningu, zwłaszcza w eksperymentach z małymi zbiorami oetykietowanymi. Niestabilność najczęściej wynika z tego, że model sam popycha się do zwracania coraz mniejszej liczby etykiet. Gdy wygenerował etykiety tylko dla części prawdziwych etykiet, uczenie się na nich zachęca go do pomijania jeszcze większej ich liczby. Dynamiczny cache prawdopodobnie powstrzymuje model przed pójściem tą drogą, bo ponownie pokazuje ten sam przykład z większą liczbą etykiet, niż wygenerowałby bieżący model. Zaproponowano też alternatywne sposoby stabilizacji treningu z użyciem wykładniczej średniej kroczącej (EMA) (link, link). W przypadku jednego z nich wykazano nawet, że skutecznie łączy się z dynamicznym cache.
Większość eksperymentów opisanych w artykułach przeprowadzono na zbiorze danych Librispeech (link), czasem z dodatkiem LibriLight (link) w eksperymentach na dużą skalę. Zbiór składa się z nagrań audiobooków czytanych przez wolontariuszy. Daje to często niezbyt wysoką jakość dźwięku i wiele akcentów, ale są to nagrania jednego mówcy o raczej stałej intonacji i tempie, z niewielką ilością emocji i szumów tła. Obecne modele rozpoznawania mowy klasy SOTA (link) osiągają 1,9% WER na zbiorze testowym clean i 3,9% na zbiorze other bez żadnych metod nienadzorowanych ani częściowo nadzorowanych. Budzi to wątpliwość, czy metody częściowo nadzorowane sprawdzą się na danych z rzeczywistego świata. (link) testuje slimIPL na danych z rozmów telefonicznych, ale te popularne zbiory (Switchboard (link), Fisher (link, link)) można zaliczyć do jednoźródłowych (jednodomenowych). Łącząc wiele modeli, można osiągnąć nawet 5% WER na odpowiadającym im zbiorze testowym, co jest nieosiągalne na rzeczywistych danych telefonicznych (link) (autorzy powiedzieli podczas prezentacji na Interspeech 2017, że na danych z rzeczywistego świata ten model miał ok. 20% WER). (link) wykorzystuje publiczne filmy jako dane treningowe dla angielskiego i włoskiego. Trudno ocenić jakość tych danych, ale podejście częściowo nadzorowane daje niemal takie same wyniki przy użyciu zaledwie 10 h danych oetykietowanych i 75 tys. h nieoetykietowanych, jak trening nadzorowany na 650 h danych oetykietowanych. Dzięki temu tworzenie modeli akustycznych jest znacznie szybsze i tańsze. Nie jest więc do końca jasne, jak pseudoetykietowanie sprawdziłoby się, gdyby dane oetykietowane pochodziły z zupełnie innej domeny akustycznej niż nieoetykietowane albo gdyby dane nieoetykietowane pochodziły z wielu domen akustycznych.
W naszych eksperymentach z pseudoetykietowaniem użyliśmy zmodyfikowanej wersji Performance Monitoring (link), aby odfiltrować pliki audio, dla których przewidywany WER jest gorszy od progu. Działa to dobrze dla dźwięku wysokiej jakości, np. danych z mediów. Korelacja między przewidywanym a rzeczywistym WER jest dość dobra, ale dla danych telefonicznych niższej jakości (8 kHz) korelacja WER nie jest wystarczająca. Eksperymenty z takimi danymi pokazują, że otrzymany model działa gorzej niż model wytrenowany wyłącznie na danych oetykietowanych.
Na podstawie naszych eksperymentów i artykułów można stwierdzić, że pseudoetykietowanie sprawdza się dobrze, jeśli dane są wysokiej jakości, a model potrafi przewidywać etykiety z dość wysoką dokładnością. Jeśli jakość dźwięku jest niższa, a nawet błąd człowieka jest dość wysoki, rozpoznania będą zawierać wiele błędów, więc w przypadku niektórych korpusów dane z pseudoetykietami mogą przynieść więcej szkody niż pożytku. Drugim argumentem przeciwko stosowaniu tej metody dla danych telefonicznych jest augmentacja danych. O ile można przyjąć, że SpecAugment nie przesuwa domeny danych, o tyle dodawanie szumu można uznać za takie przesunięcie. Najlepszym sposobem na poprawę wyników dla takich danych byłoby więc przekształcanie (augmentacja) danych lepszej jakości do postaci przybliżającej jakość telefoniczną, ale takie przesunięcie domeny to osobny obszar badań.
W porównaniu z uczeniem samonadzorowanym pseudoetykietowanie wydaje się mniej kosztowne obliczeniowo (83,2 GPU-dnia dla slimIPL wobec 294,4 dla Wav2Vec2.0 (link))(link), ale przy pracy z wieloma językami szala prawdopodobnie przechyliłaby się na drugą stronę, bo wstępnie wytrenowany model samonadzorowany łatwiej wykorzystać ponownie. Świetną wiadomością jest to, że slimIPL można łączyć z modelami takimi jak Wav2Vec2.0 i że wnosi on dodatkową wartość ponad nie (link, link). Dla zastosowań wielojęzycznych zaproponowano procedurę (link), ale w porównaniu z treningiem samonadzorowanym jest ona dość złożona.
Pseudoetykietowanie najlepiej sprawdza się więc wtedy, gdy pozostajemy w stosunkowo zamkniętej domenie i mamy dużo rzeczywistych danych przyzwoitej jakości. Zaletą jest to, że można je skonfigurować w duchu samouczącego się MLOps, który stale się doskonali, łącząc dostępne dane oetykietowane z nowo napływającymi danymi produkcyjnymi. Powinno to poprawiać model zarówno ogólnie, jak i zwłaszcza w nowych domenach, które się pojawią. Aby usprawnić proces, część najtrudniejszych odfiltrowanych przykładów można przekazywać do weryfikacji przez człowieka (human-in-the-loop), skąd wracałyby jako dane oetykietowane, poprawiając wyniki także dla danych najgorszej jakości.
Autor: Jakub Kaliski