

Rozpoznawanie mowy z RNNT - przegląd działania
 Autor: VoicelabVoiceLab
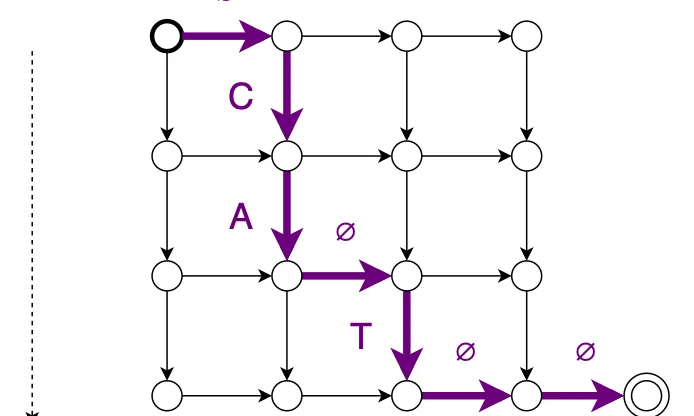
Connectionist Temporal Classification (CTC) (link) to jedno z najpopularniejszych kryteriów uczenia w rozpoznawaniu mowy. Zapewnia dobrą skuteczność i prosty trening, ale jedną z jego głównych wad jest warunkowa niezależność etykiet. Kolejną jest wymóg, by wejście było dłuższe niż wyjście. Aby rozwiązać te problemy, zaproponowano RNN Transducer (RNNT) (link). Nowa funkcja straty rozszerza mechanizmy CTC - etykietę pustą (blank) i dopasowanie ograniczone w czasie - wprowadza kilka nowych usprawnień i usuwa niedogodności.
Aby rozwiązać pierwszy problem, RNNT wprowadza nową architekturę modelu, w której sieć predyktora (Predictor Network) łączy się z siecią enkodera (Encoder Network) w sieci łączącej (Joiner Network).
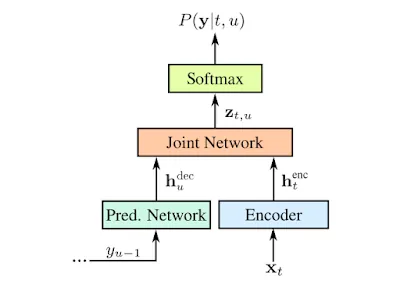
Enkoder pełni funkcję modelu akustycznego - tworzy ukrytą reprezentację cech akustycznych. Predyktor przetwarza sekwencję tokenów tekstowych, można go więc traktować jako wewnętrzny model językowy. Joiner sumuje wyjścia obu modułów i przekazuje je do prostej warstwy feedforward, która przekształca ukrytą reprezentację w rozkład prawdopodobieństwa etykiet wyjściowych. Główna idea polega na wsparciu akustycznej części rozpoznawania mowy zależnościami leksykalnymi opartymi na historii rozpoznania. Zarówno sieć enkodera, jak i predyktora można przenieść z modeli wstępnie wytrenowanych - jako enkodera można użyć modeli CTC, CE lub wytrenowanych do innych zadań, np. wav2vec, a predyktor można zainicjalizować neuronowym modelem językowym. RNNT działa w przestrzeni czasu i etykiet, dzięki czemu pozwala na wiele wyjść dla jednego wejścia, co rozwiązuje drugi problem.
Włączenie sieci predyktora może być korzystne nie tylko pod względem możliwości modelowania. Ponieważ predyktor działa wyłącznie na wejściu tekstowym, można go łatwo wstępnie wytrenować na dużej ilości danych. Ten sam mechanizm pozwala też dostosować predyktor do nowej domeny (link, link). W przeciwieństwie do audio, duże ilości danych tekstowych nadających się do treningu są łatwo dostępne. Pozwala to również wykorzystać dane użytkownika, np. listę kontaktów na urządzeniu mobilnym. Taką adaptację pojedynczego modułu można przeprowadzić bezpośrednio na urządzeniu, co zapewnia prywatność.
W odróżnieniu od standardowych modeli z mechanizmem uwagi RNNT może działać strumieniowo, nawet na urządzeniach mobilnych (link). Modele Seq-2-Seq zwykle opierają się na pełnej sekwencji wejściowej. Można ograniczyć ich wnioskowanie do bieżącego wejścia (lub wejścia z kontekstem), ale wpływa to na skuteczność. RNNT natomiast sam w sobie nie modeluje zależności czasowych, dzięki czemu od razu może działać strumieniowo. Wymuszanie takiego działania w modelach Seq-2-Seq może też wprowadzać do systemu zauważalne opóźnienie. Opóźnienie modelu RNNT można kontrolować na wiele sposobów - ograniczeniami funkcji straty wykorzystującymi dopasowania (link) lub wymuszaniem monotonicznych wyjść, strategiami dekodowania (link) albo stratami pomocniczymi (link). RNNT wydaje się dobrze sprawdzać z wyjściami w postaci fragmentów słów (wordpieces) (link, link), co pomaga utrzymać dobrą pracę w czasie rzeczywistym i złożoność obliczeniową dzięki mniejszej liczbie kroków wyjściowych.
Wszystkie te zalety mają jednak swoją cenę. Najpoważniejszą wadą jest zużycie pamięci podczas treningu. Ponieważ reprezentacje akustyczna i tekstowa mogą znacznie różnić się długością, nie da się ich po prostu dodać. Możemy połączyć dwie macierze 3D przez broadcasting, ale wymusza to ogromny narzut pamięci z powodu zbędnego dopełnienia (padding) (link). Pamiętaj, że to tylko przejście w przód - parametry trzeba przechowywać także na potrzeby propagacji wstecznej. Obok typowych sposobów zmniejszania zużycia pamięci, takich jak użycie połowicznej precyzji czy trening na przykładach posortowanych według długości, zaproponowano kilka nowych technik. Broadcasting zastąpiono łączeniem osobno dla każdej wypowiedzi (link), a następnie konkatenacją, dzięki czemu do krótszych przykładów nie trafia dodatkowe dopełnienie. W tym samym artykule funkcję softmax włączono do obliczania straty, co pozwala zaoszczędzić dodatkową pamięć przy dużej liczbie fragmentów słów. Niedawno zespół projektu k2 podjął się optymalizacji zużycia pamięci przez RNNT. Zaimplementował część zaproponowanych już rozwiązań (Recurrent Neural Aligner - ograniczony wariant RNNT, który może emitować tylko jeden symbol na ramkę), a także kilka nowych pomysłów, takich jak przycinany RNNT (pruned RNNT). To podejście minimalizuje zużycie pamięci, usuwając zerowe gradienty z propagacji wstecznej.
Predyktor może też wprowadzać do modelu obciążenie ekspozycyjne (exposure bias) - trening na małej ilości danych może prowadzić do przeuczenia i problemów z generalizacją. Część metod zapobiegania temu dotyczy bezpośrednio procedury treningu (link), inne proponują zmiany architektury (link) lub sztuczki w potoku treningowym (link). Z powodu wszystkich wymienionych kwestii trenowanie i diagnozowanie modeli RNNT bywa wymagające.
Mimo tych problemów RNNT zyskuje coraz więcej uwagi, a lista frameworków oferujących RNNT stale rośnie. Oto niektóre z nich:
Istnieją też samodzielne implementacje oferujące powiązania (bindings) z popularnymi bibliotekami, takimi jak PyTorch czy Tensorflow (link). Co zaskakujące, nie ma oficjalnej implementacji w Tensorflow, choć Google wydaje się angażować w rozwój RNNT (link). Wydajne implementacje RNNT z projektu k2 są dostępne jako osobne moduły (link).
Podsumowując, uważamy, że RNNT może prowadzić do dalszych postępów w rozpoznawaniu mowy. Włączenie aspektu językowego bezpośrednio do modelu akustycznego może poprawić zdolność generalizacji, zwłaszcza w trudnych warunkach akustycznych. Adaptacja predyktora wyłącznie na danych tekstowych może być prostym sposobem radzenia sobie z nowymi danymi lub danymi spoza domeny. Pamiętaj, że dotąd rozważaliśmy wyłącznie systemy ASR bez zewnętrznego modelu językowego. O ile w konwencjonalnych systemach integracja modelu językowego jest dość prosta, o tyle RNNT oferuje kilka strategii fuzji, takich jak głęboka (deep), płytka (shallow) czy zimna (cold). (link)
Wydaje się, że RNNT może prowadzić do wyników na poziomie SOTA w niektórych produktach, np. w systemach na urządzenia mobilne lub aplikacjach strumieniowych. Modułowa konstrukcja pozwala używać wstępnie wytrenowanych sieci enkodera i predyktora jako jednego potoku end-to-end i znacznie upraszcza system rozpoznawania mowy. Wraz z rosnącym zainteresowaniem zespołów badawczych RNNT będzie się poprawiać pod względem zużycia pamięci, stabilności treningu i ogólnej skuteczności.
Autor: Jakub Filipiuk