

Alternatywna, lekka strategia dostrajania dużych modeli językowych z użyciem Adapter Fusion
 Autor: VoicelabVoiceLab
Pfeiffer i in. (https://arxiv.org/pdf/2007.07779.pdf)
Motywacja
Współczesne modele językowe, takie jak T5 czy Bert, są ogromne. Bazowa wersja T5 ma do 220 milionów parametrów i zajmuje setki megabajtów pamięci. Wyobraź sobie, ile czasu i zasobów pochłania trenowanie takiego modelu. Na szczęście istnieje idea uczenia transferowego (Transfer Learning), polegająca na tym, że autorzy - zwykle duże firmy technologiczne i ośrodki badawcze - udostępniają swoje wytrenowane modele. Każdy może łatwo pobrać wstępnie wytrenowany model i dostroić go (fine-tuning) do konkretnego zadania.
Alternatywą dla dostrajania jest koncepcja małych warstw dedykowanych konkretnym zadaniom, zwanych adapterami. Moduły adapterów wyróżniają się zwartością - stanowią od 0,2 do 4% rozmiaru modelu.
Na wykresie poniżej wyraźnie widać, że adaptery radzą sobie równie dobrze jak dostrajanie górnych warstw, mimo że mają o dwa rzędy wielkości mniej parametrów. Poziom 0 na osi Y oznacza wynik w pełni dostrojonego modelu (wszystkie warstwy, nie tylko górne).
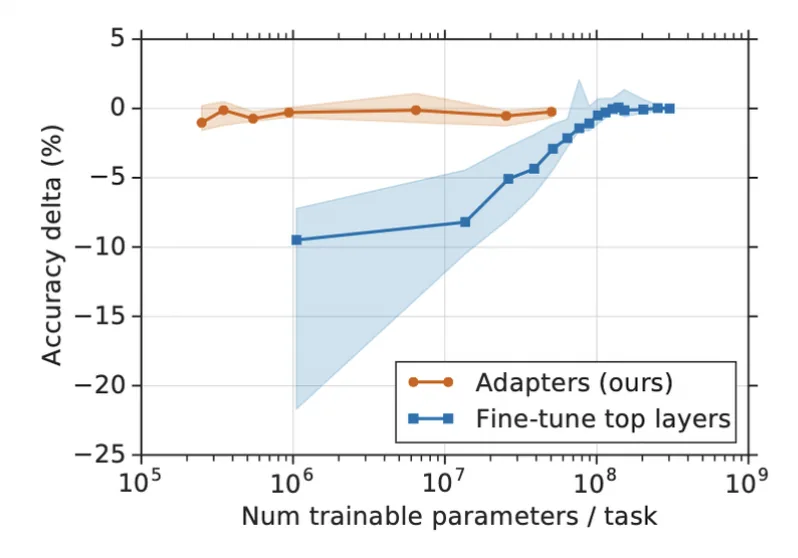
Houlsby i in. (https://arxiv.org/pdf/1902.00751.pdf)
Trochę liczb z testów przeprowadzonych przez Houlsby’ego i współpracowników. CoLA, SSt itd. to standardowe zbiory danych benchmarkowych w dziedzinie NLP.
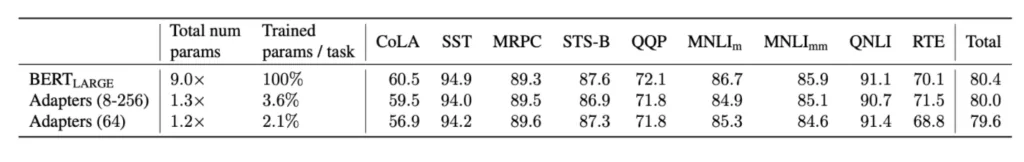
Houlsby i in. (https://arxiv.org/pdf/1902.00751.pdf)
Kolejnym ważnym aspektem, w którym adaptery i ich fuzja odgrywają istotną rolę, jest niesławne zjawisko katastrofalnego zapominania (Catastrophic Forgetting), które wyjaśnimy w trzeciej sekcji.
Czym jest adapter?
Koncepcja adapterów w transformerach pochodzi od Houlsby’ego i współpracowników (2019) z artykułu „Parameter-Efficient Transfer Learning for NLP”. W pierwotnej wersji składa się z dwóch małych dodatkowych bloków wewnątrz warstwy kodera w architekturze Transformer. Podczas treningu całkowicie zamrażamy parametry modelu, a trenowane są wyłącznie parametry adapterów.
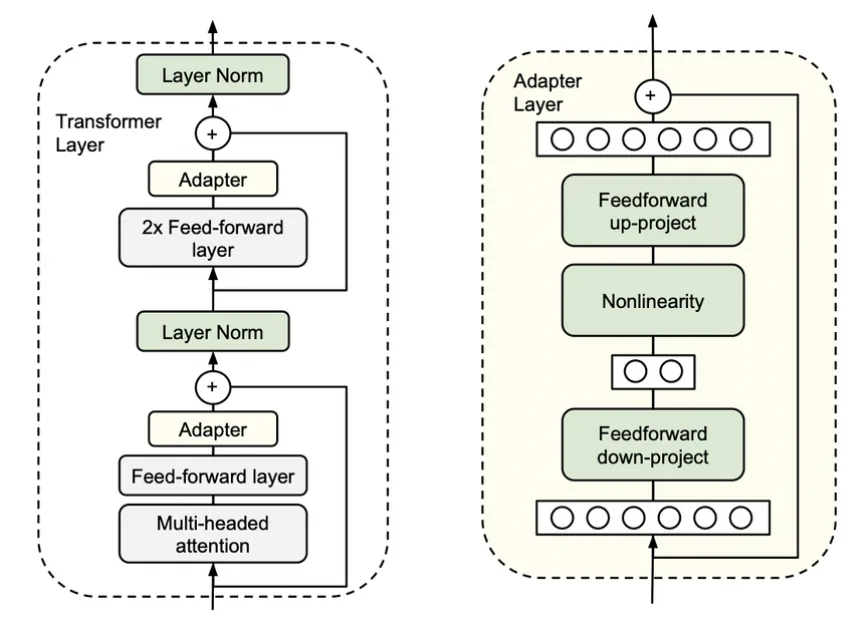
Houlsby i in. (https://arxiv.org/pdf/1902.00751.pdf)
Adapter to nic innego jak kolejny ekstraktor cech i informacji o architekturze „wąskiego gardła” (bottleneck). Przetwarzane dane są rzutowane do niższego wymiaru, aby odfiltrować tylko kluczowe informacje. Na końcu są przekształcane z powrotem do pierwotnego rozmiaru, by spełnić wymagania modelu. Taką konfigurację nazywamy od nazwiska autora „architekturą Houlsby’ego”. Istnieją też inne pomysły z tylko jedną warstwą adaptera, np. „architektura Pfeiffera”, która jest lżejsza, a spadek wydajności jest pomijalny.
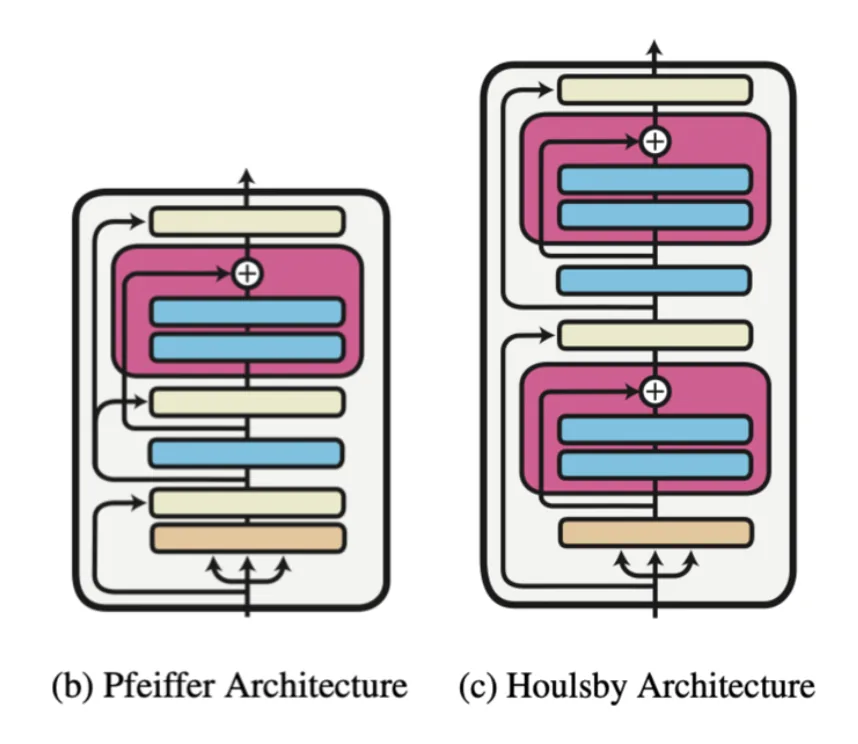
Pfeiffer i in. (https://arxiv.org/pdf/2005.00247.pdf)
Badacze i praktycy najczęściej używają architektury Houlsby’ego, ponieważ jest to konfiguracja bazowa, a istnieje hipoteza, że brak adapterów w ostatniej warstwie transformera jest korzystny. Adaptery we wszystkich warstwach kodera z wyjątkiem ostatniej są otoczone zamrożonymi warstwami feed-forward. Oznacza to, że są od siebie oddzielone. Architektura Pfeiffera w ostatnich warstwach praktycznie nie ma adaptera, ponieważ stanowi on część głowicy predykcyjnej. Natomiast architektura Houlsby’ego ma jeden adapter po warstwie multi-head attention, przykryty od góry zamrożoną warstwą feed-forward. Drugi jest rozszerzeniem głowicy predykcyjnej.
Kluczowa idea polega na tym, że adapter działa jako ekstraktor informacji dla konkretnego zadania, co będzie istotne w kolejnej sekcji.
Czym jest adapter fusion?
Skoro wiemy już, czym są adaptery, możemy wytrenować ich zestaw - każdy do osobnego zadania. Idea fuzji polega na połączeniu adapterów dedykowanych zadaniom za pomocą pojedynczej warstwy fuzji, podobnej do warstwy uwagi. Zarówno warstwa uwagi, jak i warstwa fuzji wykorzystują to samo równanie i algorytm do obliczania wyjścia.
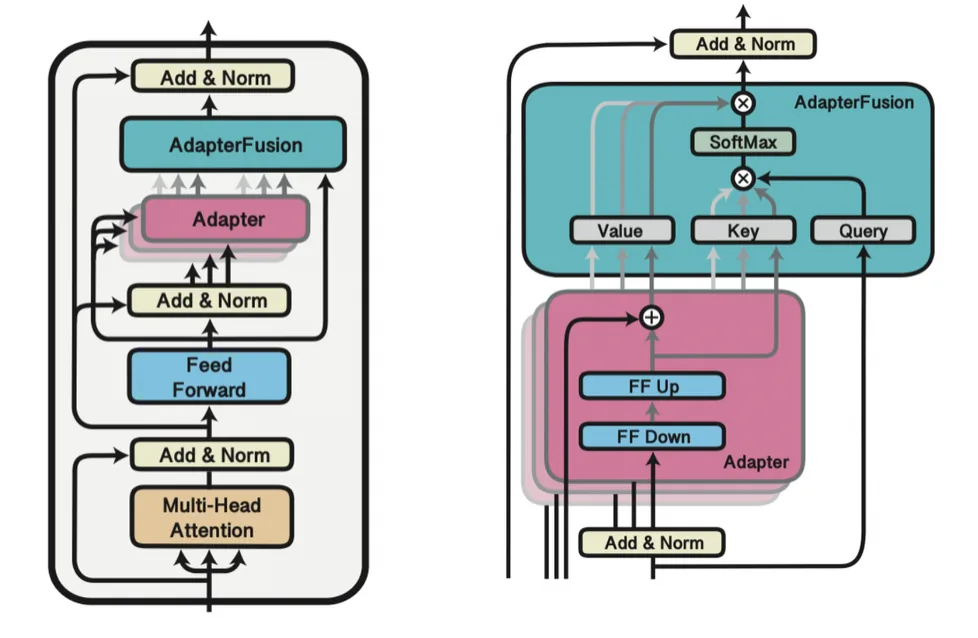
Pfeiffer i in. (https://arxiv.org/pdf/2005.00247.pdf)
Warstwa fuzji uczy się rozpoznawać i aktywować najbardziej przydatny adapter dla danego wejścia. Ogólna zasada jest taka, że adaptery w niższych warstwach są bardziej ogólne, więc aktywują się częściej. Z kolei adaptery w górnych warstwach skupiają się na szczegółach. Co więcej, Adapter Fusion wydobywa informacje z adapterów tylko wtedy, gdy są one korzystne dla konkretnego zadania.
Trening Adapter Fusion można podzielić na dwa etapy.
- Krok 1. Zamrażamy parametry modelu i trenujemy adaptery - ekstrakcja wiedzy
- Krok 2. Zamrażamy parametry modelu i adapterów, a następnie trenujemy warstwy fuzji - kompozycja wiedzy
Uczenie ciągłe i few-shot
Aspekt ciągłości uczenia (Continual Learning) dotyczy sytuacji, w których wytrenowaliśmy model, a po pewnym czasie pojawiają się nowe dane o innym rozkładzie. W trybie dostrajania musielibyśmy ponownie wytrenować model na wszystkich zgromadzonych danych. Byłoby to nie tylko bardzo czasochłonne, ale też - ponieważ model uczy się nowych wzorców - wagi zostałyby nadpisane. Prowadzi to do zapominania wcześniejszej wiedzy. Zjawisko to nazywamy katastrofalnym zapominaniem.
Adaptery pomagają uniknąć tej typowej pułapki uczenia wielozadaniowego. Nowe adaptery uczą się wiedzy potrzebnej do nowych zadań, a starych nie trzeba nadpisywać. Fuzja łączy adaptery, ucząc się, który adapter i kiedy powinien zostać aktywowany.
Czasem jesteśmy zmuszeni pracować z niewielką ilością danych - w scenariuszu few-shot. To kolejny obszar, w którym adaptery dobrze się sprawdzają dzięki stosunkowo niewielkiej architekturze. W następnej sekcji zobaczymy, jak radzą sobie na małym zbiorze danych.
Adapter Fusion w akcji!
Zaimplementujemy adapter fusion z modelem Bert przy użyciu Pytorch i biblioteki transformers. [1]
Pobierzemy i wczytamy zbiór danych CommitmentBank (De Marneffe i in., 2019).
from datasets import load_dataset
dataset = load_dataset("super_glue", "cb")
print(dataset.num_rows)
-> {'test': 250, 'train': 250, 'validation': 56}
Ten zbiór danych zawiera 556 przykładów, z których każdy składa się z przesłanki i hipotezy. Celem jest klasyfikacja relacji między nimi: czy jest to „entailment” (wynikanie), „contradiction” (sprzeczność), czy „neutral” (relacja neutralna).
Pierwszym krokiem jest zakodowanie danych dla wybranego modelu Bert (bert-base-uncased z hugging face).
from transformers import BertTokenizer
tokenizer = BertTokenizer.from_pretrained("bert-base-uncased")
def encode_batch(batch):
    """Encodes a batch of input data using the model tokenizer."""
    return tokenizer(
         batch["premise"],
         batch["hypothesis"],
         max_length=180,
         truncation=True,
          padding="max_length")
# Encode the input data
dataset = dataset.map(encode_batch, batched=True)
# The transformers model expects the target class column to be named "labels"
dataset = dataset.rename_column("label", "labels")
# Transform to pytorch tensors and only output the required columns
dataset.set_format(type="torch", columns=["input_ids", "attention_mask", "labels"])
Następnie możemy utworzyć instancję Berta z odpowiednią konfiguracją i etykietami.
from transformers import BertConfig, BertModelWithHeads
# Preparing labels equivalent
id2label = {id: label for (id, label) in enumerate(dataset["train"].features["labels"].names)}
config = BertConfig.from_pretrained(
                 "bert-base-uncased",
                 id2label=id2label,
)
 model = BertModelWithHeads.from_pretrained(
                    "bert-base-uncased",
                    config=config,
)
Później możemy dodać adaptery (używamy wstępnie wytrenowanych z adapterhub) bez głowic klasyfikacyjnych i je aktywować. Wszystkie są w konfiguracji Houlsby’ego i zostały wytrenowane na różnych zbiorach danych dedykowanych zadaniom:
- STS - (http://ixa2.si.ehu.eus/stswiki/index.php/STSbenchmark)
- nli - część benchmarku GLUE (https://gluebenchmark.com)
- multinli - (https://cims.nyu.edu/~sbowman/multinli/)
Na to nakładamy warstwę adapter fusion i przykrywamy ją losowo zainicjalizowaną głowicą klasyfikacyjną, którą nazywamy „cb”.
from transformers.adapters.composition import Fuse

# Load the pre-trained adapters we want to fuse
model.load_adapter("nli/multinli@ukp", load_as="multinli", with_head=False)
model.load_adapter("sts/qqp@ukp", load_as="sts", with_head=False)
model.load_adapter("nli/qnli@ukp", load_as="nli", with_head=False)
# Add a fusion layer for all loaded adapters
model.add_adapter_fusion(Fuse("multinli", "qqp", "qnli"))
model.set_active_adapters(Fuse("multinli", "qqp", "qnli"))
# Add a classification head for our target task
model.add_classification_head("cb", num_labels=len(id2label))
Czas zamrozić parametry modelu i adapterów. Trenować trzeba tylko warstwy fuzji.
# Unfreeze and activate fusion setup
adapter_setup = Fuse("multinli", "qqp", "qnli")
model.train_adapter_fusion(adapter_setup)
Ostatnim krokiem jest przygotowanie metryki ewaluacji i części treningowej.
import numpy as np from transformers
import TrainingArguments, AdapterTrainer, EvalPrediction
training_args = TrainingArguments(
                      learning_rate=5e-5,
                      num_train_epochs=5,
                      per_device_train_batch_size=32,
                      per_device_eval_batch_size=32,
                      logging_steps=200,
                      output_dir="./training_output",
                      overwrite_output_dir=True,
                      # The next line is important to ensure the dataset labels are properly passed to the model
                      remove_unused_columns=False,
)
def compute_accuracy(p: EvalPrediction):
   preds = np.argmax(p.predictions, axis=1)
   return {"acc": (preds == p.label_ids).mean()}
trainer = AdapterTrainer(
                model=model,
                args=training_args,
                train_dataset=dataset["train"],
                eval_dataset=dataset["validation"],
                compute_metrics=compute_accuracy,
)
# Train model
trainer.train()
Następnie możemy ocenić nasz model po fuzji - osiąga on aż 71% dokładności (accuracy)!
print(trainer.evaluate())
 -> {'eval_loss': 0.7297406792640686,
     'eval_acc': 0.7142857142857143,
     'eval_runtime': 1.1516,
     'eval_samples_per_second': 48.628,
     'eval_steps_per_second': 1.737,
     'epoch': 5.0}
Czas na podsumowanie
Jak widzieliśmy, Adapter Fusion to ciekawa, kompaktowa metoda uczenia transferowego. Pozwala osiągnąć wyniki bliskie SoTA, ale znacznie mniejszym nakładem pracy i czasu. Co więcej, adaptery dobrze sprawdzają się w trybach few-shot i uczenia ciągłego (Continual Learning) oraz pozwalają stawić czoła problemowi katastrofalnego zapominania.
Źródła
Autor: Beniamin Sereda