

Czym jest MAML i jak go użyć w NLP?
 Autor: VoicelabVoiceLab
Czym jest MAML i jak go użyć w NLP?
Algorytmy uczenia maszynowego mają dziś coraz więcej zastosowań, a to oznacza, że potrzebujemy coraz więcej różnorodnych danych. Mimo ogromnych centrów danych z niewyobrażalną ilością informacji wciąż zdarzają się przypadki, które wymagają danych unikalnych - na przykład w specyficznych zastosowaniach badawczych albo w zadaniach typu few-shot learning.
Few-shot learning to rodzaj problemu uczenia maszynowego, w którym do treningu mamy tylko kilka próbek danych. W takiej sytuacji na ratunek przychodzi MAML. Skrót ten oznacza Model-Agnostic Meta-Learning, czyli meta-uczenie niezależne od modelu.
Meta-uczenie (meta-learning) oznacza uczenie się umiejętności uczenia się. Celem jest przygotowanie modelu do szybkiej adaptacji. Zamiast trenować model na setkach zdjęć psów, aby rozpoznawał psy, uczymy go rozpoznawać różnice między zdjęciami zwierząt. Możemy na przykład nauczyć model rozróżniać wielkość łap i uszu, kolory i kształty, aby klasyfikował zwierzęta.
Idea metody MAML, opracowanej przez Chelsea Finn, Pietera Abbeela i Sergeya Levine’a w 2017 roku [1], polega na meta-uczeniu na małych zadaniach, które prowadzi do umiejętności szybkiego uczenia się. Dzięki temu możemy ją stosować wtedy, gdy ilość danych nie wystarcza innym metodom. W tym wpisie skupimy się na zastosowaniach MAML w NLP, w tym na klasyfikacji tekstu w trybie few-shot, ale najpierw musimy coś wyjaśnić.
MAML to metoda, której kroki mają następującą strukturę: dla każdego zadania tworzymy kopię używanego modelu, następnie trenujemy ją na zbiorze wsparcia (support set), obliczamy stratę na zbiorze zapytań (query set), sumujemy straty i wykonujemy propagację wsteczną, co zamyka pętlę. Ta metoda pozwala trenować modele przy niewielkich zasobach danych.
Meta-zadanie (Meta-Task) to reprezentacja danych w procesie treningu. Oryginalny zbiór danych dzielimy na mniejsze zadania, które zawierają kilka lub więcej próbek, dzięki czemu model uczy się rozpoznawać nowe klasy na podstawie niewielu przykładów.
Przegląd danych
Przede wszystkim chcieliśmy przetestować tę metodę na dwóch typach danych wejściowych, aby sprawdzić, jak struktura tekstu wpływa na jej działanie dla tekstów krótkich i długich:
- jedno krótkie zdanie,
- kilka zdań.
W naszym przypadku trenowaliśmy i testowaliśmy metodę na dwóch zbiorach danych. Pierwszy zawierał kilkuzdaniowe teksty z różnych dziedzin nauki z etykietą dziedziny [2], a drugi - krótkie, jednozdaniowe polecenia dla osobistego asystenta z etykietą intencji [3].
Ze zbioru danych z dziedzinami nauki o nazwie Curlicat wybraliśmy 6 klas, które jednoznacznie wskazują jedną dziedzinę. Zbiór danych osobistego asystenta zawierał 64 klasy i 8954 próbki. Z myślą o few-shot learningu użyliśmy 16 klas po 10 próbek na klasę.
Przygotowanie danych
Wspomniane zbiory danych wymagały wstępnego przetworzenia, aby poprawić wyniki i spełnić wymagania używanego modelu. Dlatego usunęliśmy duplikaty i upewniliśmy się, że żaden tekst nie przekracza 512 znaków.
Na koniec podzieliliśmy dane na meta-zadania, które zawierają próbki zbioru wsparcia i zbioru zapytań:
- zbiór wsparcia zawiera teksty z etykietami, na których model się uczy,
- zbiór zapytań zawiera teksty bez etykiet, dla których model wykonuje predykcję
Trening
Przed ostatecznym treningiem poświęciliśmy trochę czasu na poszukiwanie najlepszych hiperparametrów i ustaliliśmy, że kilka przykładów na meta-zadanie daje zadowalający wynik i jest idealne do few-shot learningu.
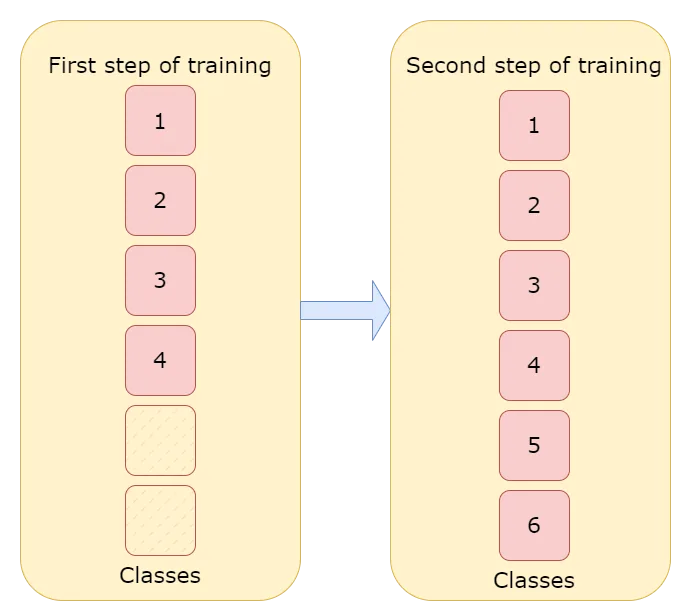
W przypadku zbioru danych Curlicat trening przebiegał w dwóch krokach. Najpierw wytrenowaliśmy model na 4 klasach po 100 próbek na klasę, a następnie przeprowadziliśmy drugi trening na 6 klasach po 10 próbek na klasę, aby sprawdzić, czy testowana metoda potrafi nauczyć się dodatkowych klas na podstawie kilku próbek i uniknąć zapominania.
Ze względu na prostą strukturę zbioru danych osobistego asystenta przeprowadziliśmy na nim tylko jeden trening na 16 klasach po 10 próbek na klasę.
Czas potrzebny na trening modelu trudno oszacować z powodu niestabilnej natury tej metody. Pierwszy etap jest jednak bardziej przewidywalny i powtarzalny - w naszym przykładzie obniżenie straty zajęło 2-3 godziny. Drugi etap zależy od kolejności próbek treningowych i może trwać od godziny do 3-4 godzin.
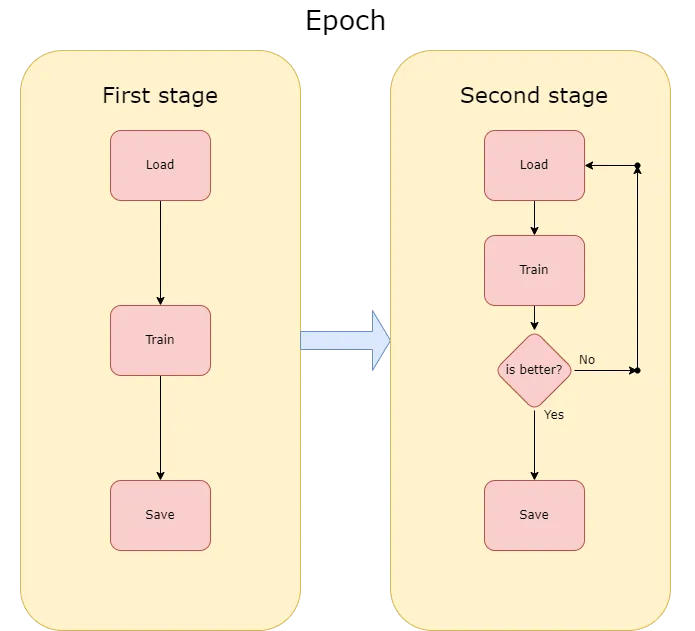
Dodatkowo każdy krok składał się z dwóch etapów. W naszym przypadku metoda okazała się niestabilna: mimo niskiej straty treningowej predykcje na zbiorze walidacyjnym były bardzo niestabilne i zmieniały się z 40% na 50%, a potem z powrotem na 40%, a nawet 30%. Aby temu zapobiec, wprowadziliśmy etapy. W pierwszym etapie obniżamy stratę treningową i zapisujemy model po każdej epoce, a w drugim zapisujemy model tylko wtedy, gdy metryka F1 z bieżącej epoki jest lepsza niż F1 z poprzedniej. Takie rozwiązanie pozwoliło nam wytrenować niestabilną metodę do wysokiej trafności predykcji.
Wyniki
Do przedstawienia wyników użyliśmy metryk accuracy i F1. W pierwszym kroku testowaliśmy metodę na 100 próbkach na klasę, a w drugim - na 300 próbkach na klasę. W pierwszym kroku treningu uzyskaliśmy 75% accuracy i 66,6% F1 - metoda poprawnie rozpoznała 3 z 4 klas. W drugim kroku, czyli w kroku few-shot learningu, uzyskaliśmy 83,3% accuracy i 77,8% F1, co jest wynikiem nawet lepszym niż w pierwszym kroku. To prowadzi nas do wniosku, że nauczyliśmy model się uczyć. W przypadku zbioru danych osobistego asystenta, po jednym treningu na 16 klasach po 10 próbek na klasę, uzyskaliśmy 70% F1 przy testowaniu wyłącznie drugiego kroku, co jest wynikiem zbliżonym do zbioru Curlicat
Możliwe usprawnienia
Jednym z przyszłych usprawnień może być zmiana sposobu dodawania nowych klas do modelu. Obecnie miejsce na nowe klasy jest rezerwowane podczas tworzenia modelu, co może doprowadzić do sytuacji, w której zabraknie miejsca na nową klasę. Rozwiązaniem jest dynamiczne tworzenie nowych miejsc przy dodawaniu klas, co można osiągnąć przez modyfikację warstwy klasyfikacyjnej. Tracimy jednak wtedy wytrenowane wagi, co wymusza drugi trening z zamrożonymi wagami, a ten jest bardzo czasochłonny.
Podsumowanie
Ten przypadek jasno pokazuje, że w niektórych sytuacjach nie potrzebujemy tysięcy rekordów, aby skutecznie wytrenować model uczenia maszynowego - może wystarczyć kilka lub kilkanaście próbek. Osiągnięcie wysokiej trafności może być jednak wyzwaniem.
Źródła
1. Chelsea Finn, Pieter Abbeel, Sergey Levine. ‘Model-Agnostic Meta-Learning for Fast Adaptation of Deep Networks’, 2017.
https://doi.org/10.48550/arXiv.1703.03400
2. Váradi, Tamás, Bence Nyéki, Svetla Koeva, Marko Tadić, Vanja Štefanec, Maciej Ogrodniczuk, Bartłomiej Nitoń, Piotr Pęzik et al. ‘Introducing the CURLICAT Corpora: Seven-Language Domain Specific Annotated Corpora from Curated Sources’. In Proceedings of the Language Resources and Evaluation Conference, 100-108. Marseille, France: European Language Resources Association, 2022.
http://www.lrec-conf.org/proceedings/lrec2022/pdf/2022.lrec-1.11.pdf.
Autor: Szymon Mielewczyk