

Klasyfikacja skarg klientów na podstawie danych Consumer Financial Protection Bureau
 Autor: VoicelabVoiceLab
Kontekst biznesowy
Znajomość klienta to klucz do sukcesu w marketingu. Przedsiębiorstwa gromadzą coraz więcej danych o klientach. Robią to jawnie lub po cichu. Czasem, pytając o jakość obsługi, firma chce poznać potrzeby klienta i odpowiednio dopasować do nich ofertę.
Wynika to z dużej konkurencji i chęci jak najlepszego dopasowania oferty.
Analiza danych o klientach to bardzo złożone zagadnienie, które dotyczy wielu branż. Jednym z rodzajów danych o wysokiej wartości dodanej są skargi składane na usługi lub produkty.
Celem tego zadania jest kategoryzacja skarg kierowanych do firmy za pomocą uczenia maszynowego. Dzięki temu skarga trafi do właściwego działu i zostanie szybciej rozpatrzona.
Przegląd danych
Ponieważ temat jest bardzo obszerny, postanowiliśmy przeanalizować dane o skargach z Consumer Financial Protection Bureau (CFPB), amerykańskiej agencji federalnej. Dane zostały pobrane z oficjalnej strony, są napisane po angielsku i obejmują skargi dotyczące konsumenckich produktów i usług finansowych, które CFPB przekazało firmom do odpowiedzi. Zbiór danych obejmuje ponad 4 lata zachowań klientów w tym obszarze (pierwsze rekordy pochodzą z 2017 roku). Łącznie zebrano 28 864 zanonimizowane skargi wraz z metadanymi.
Wstępne przetwarzanie danych
Podczas analizy danych pracowano wyłącznie na wyodrębnionych kolumnach najważniejszych dla procesu: product, issue, subissue, narrative.
Skargi dotyczyły następujących produktów:
- Raportowanie kredytowe, usługi naprawy historii kredytowej lub inne raporty o konsumentach (19609)
- Windykacja należności (4694)
- Karta kredytowa lub przedpłacona (2790)
- Rachunek bieżący lub oszczędnościowy (1692)
- Kredyt hipoteczny (79)
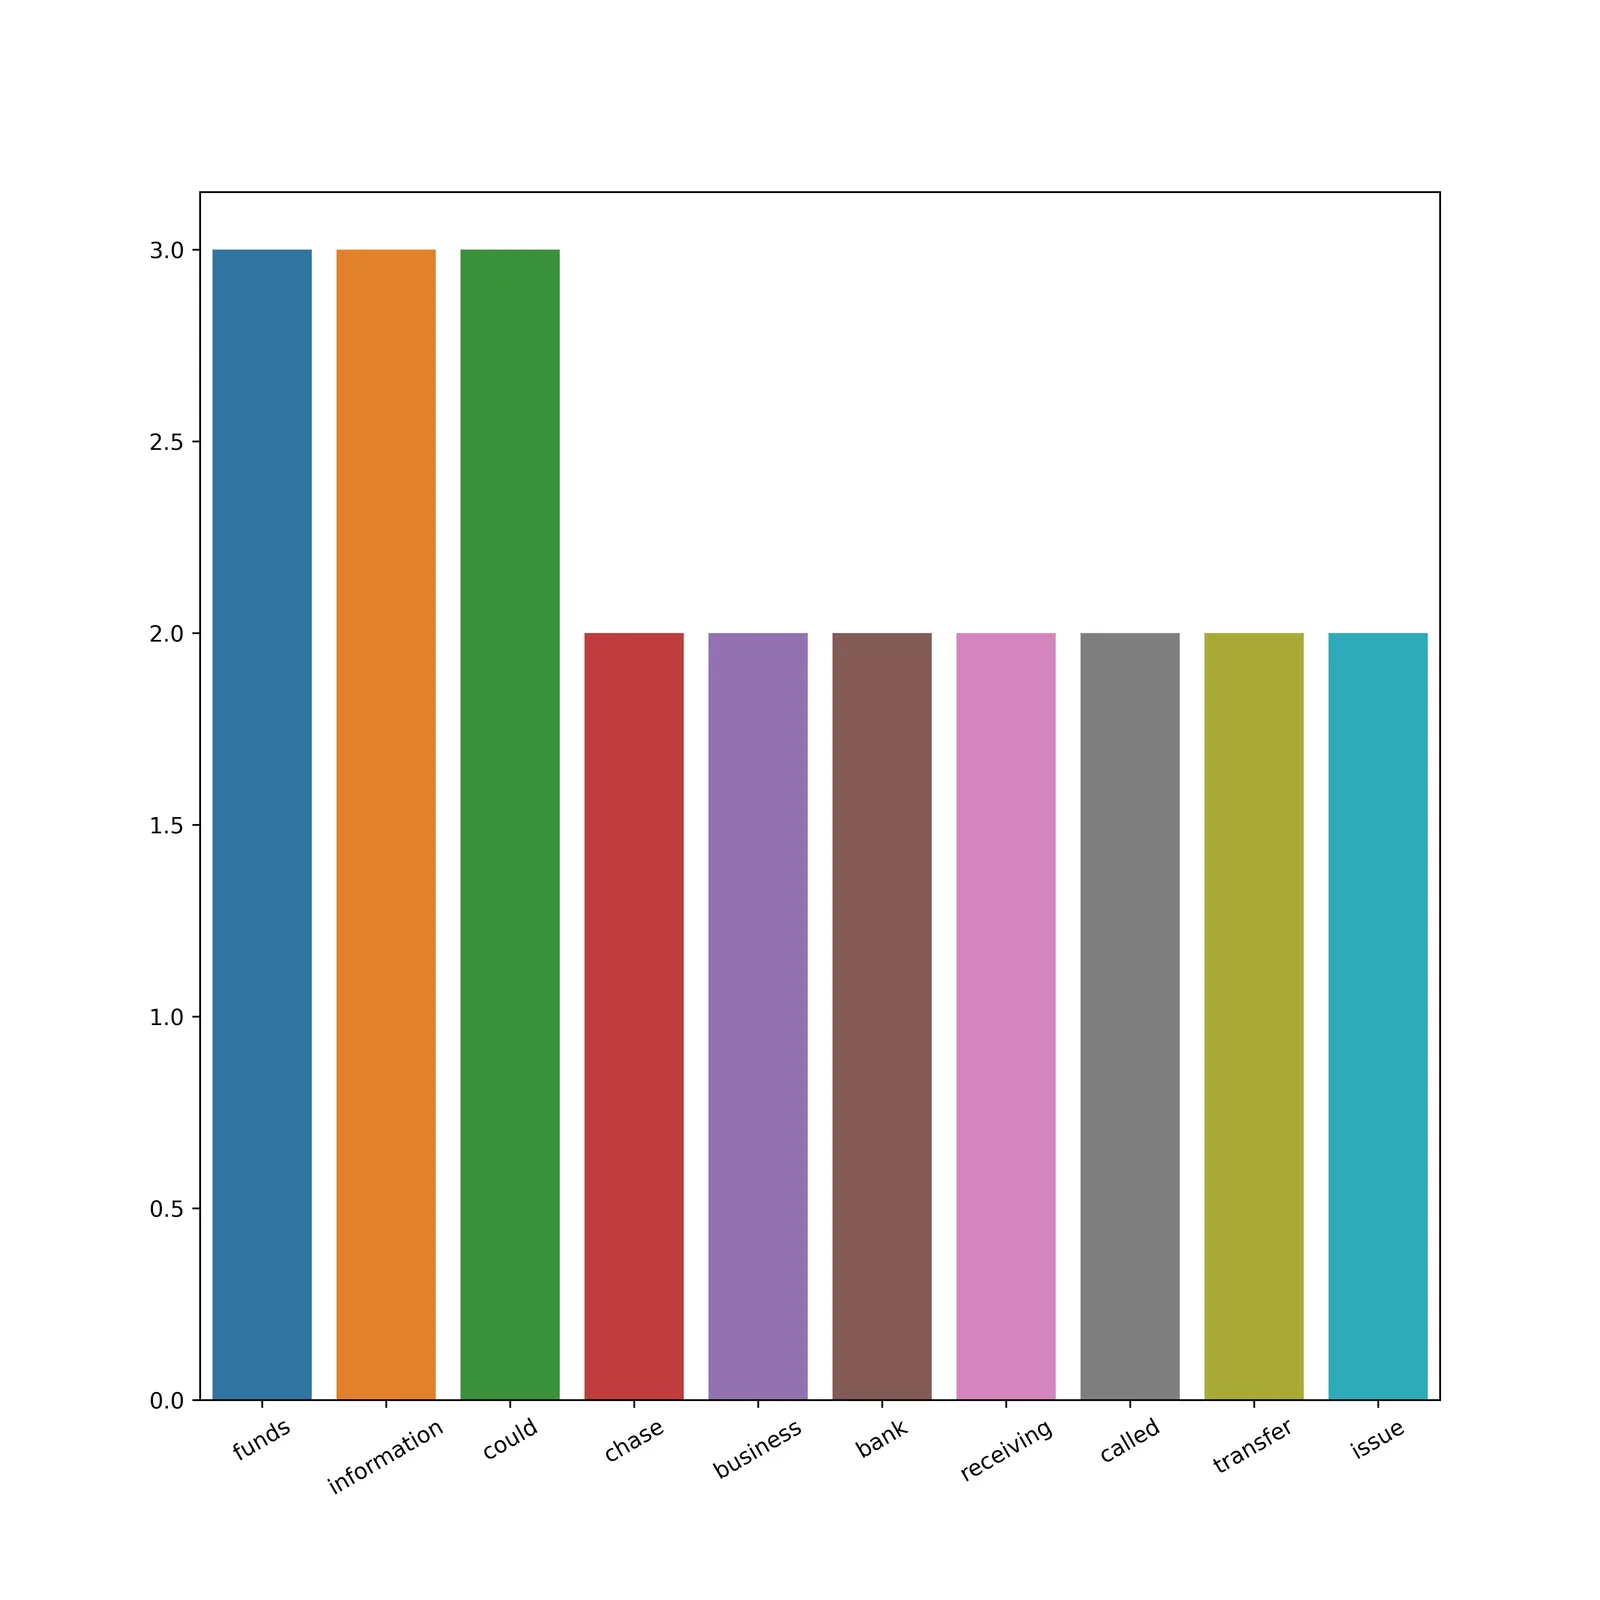
W ramach przetwarzania danych wykorzystano bibliotekę NLTK. Zbiór danych został poddany tokenizacji, a następnie usunięto z niego słowa funkcyjne (stopwords), liczby i brakujące dane. Większość z 20 najczęstszych tokenów można uznać za słowa funkcyjne.
Przeprowadzono również analizę częstości. Najczęstsze słowa to np.: account, report, credit, verified.
Zmieniono też nazwy głównych kategorii produktów, aby łatwo było je wpisywać.
Kredyty hipoteczne i pożyczki połączono ze względu na niewielką liczebność. Połączono także zestaw informacji dotyczących skargi, aby uzyskać o niej pełną informację. Przykładowa skarga wygląda następująco:
Hello This complaint is against the three credit reporting companies. XXXX, XXXX XXXX and equifax. I noticed some discrepencies on my credit report so I put a credit freeze with XXXX.on XX/XX/2019. I then notified the three credit agencies previously stated with a writtent letter dated XX/XX/2019 requesting them to verifiy certain accounts showing on my report They were a Bankruptcy and a bank account from XXXX XXXX XXXX.
Potok modelowania
Pierwszym krokiem modelowania była wektoryzacja - utworzono macierz TF-IDF (z max_features= 5000000). W drugim eksperymencie dane przekształcono za pomocą CountVectorizer. Przeprowadzono lematyzację z użyciem WordNetLemmatizer.
Przed właściwym modelowaniem macierz podzielono na zbiór treningowy (80%) i zbiór testowy (20%). Zmienną docelową pozostał produkt.
| product | narrative | |
|---|---|---|
| 0 | retail_banking | wife wired money personal account joint chase … |
| 1 | debt_collection | today individual sheriff department delivered … |
| 2 | credit_reporting | hello complaint three credit reporting company… |
Przetestowano następujące typy modeli:
- Random Forest,
- Decision Tree,
- KNN,
- Gradient Boosting
Najpierw z parametrami domyślnymi, a następnie z kilkoma wariantami doboru parametrów.
Najlepszy wynik uzyskano za pomocą drzewa decyzyjnego (Decision Tree) z CountVectorizer:
Accuracy: 94,5%
Precision: 95,4%
Recall: 75,9%
F1: 79,8%
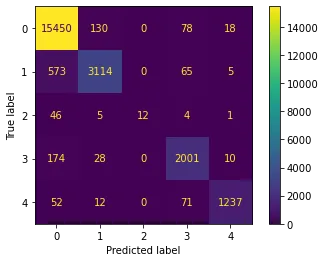
Ze względu na niezbalansowane klasy zastosowano także SMOTE. Wszystkie modele dawały podobne wyniki na zbiorze treningowym i testowym, co oznacza, że nie doszło do przeuczenia.
Drugi pod względem wyników był KNN:
Accuracy: 87,7%
Precision: 67,7%
Recall: 60,9%
F1: 63,8%
Uwagi
Warto zauważyć, że jednym z większych ograniczeń tego zadania jest ilość danych, a raczej liczba zmiennych tworzonych dla tekstu. W przypadku modeli, których jakość można poprawić przez przeszukiwanie hiperparametrów, są to już procesy trwające godzinę. Kolejna kwestia jest taka, że to typowa sytuacja przy analizie tekstu.
Powyższe zadanie dowodzi, że uczenie maszynowe na tekście swobodnym może być bardzo korzystne dla przedsiębiorstwa. Możliwość automatycznej klasyfikacji przychodzących dokumentów pozwala znacznie zaoszczędzić na kosztach pracy ludzkiej. Modele opracowane w ramach pierwszych prób dają przyzwoite wyniki.
Autor: Karolina Wadowska