

Część 2: Abstrakcyjne streszczanie tekstu - o co w nim chodzi?
 Autor: VoicelabVoiceLab
Streszczanie tekstu to zadanie polegające na tworzeniu nowej, krótszej wersji tekstu wejściowego przez ograniczenie liczby słów i zdań bez zmiany ich znaczenia i z zachowaniem kluczowych fragmentów.
Istnieje wiele technik wydobywania najważniejszych informacji z tekstu wejściowego, ale większość z nich należy do jednego z dwóch podejść: ekstrakcyjnego lub abstrakcyjnego. W tym artykule dowiesz się więcej o abstrakcyjnym streszczaniu tekstu.
Modele
Uczenie transferowe, w którym model jest najpierw wstępnie trenowany na zadaniu z dużą ilością danych, a następnie dostrajany (fine-tuning) do zadania docelowego, stało się skuteczną techniką przetwarzania języka naturalnego (NLP). Skuteczność uczenia transferowego dała początek różnorodnym podejściom, metodologiom i praktykom. Jeśli dopiero zaczynasz przygodę ze streszczaniem tekstu, powinieneś poznać BART i T5.
Zanim przejdziemy do tych modeli, powiedzmy kilka słów o BERT. Model ten został przedstawiony w 2018 roku przez Google. Jest wstępnie trenowany do przewidywania zamaskowanych tokenów i wykorzystuje całą sekwencję, aby zebrać wystarczająco dużo informacji do trafnego odgadnięcia. Sprawdza się to dobrze w zadaniach, w których przewidywanie na pozycji i może korzystać z informacji z pozycji po i, ale jest mniej przydatne w zadaniach takich jak generowanie tekstu, gdzie przewidywanie dla pozycji i może zależeć wyłącznie od wcześniej wygenerowanych słów.
BART i T5 różnią się od BERT tym, że:
- dodają dekoder przyczynowy (causal decoder) do dwukierunkowej architektury enkodera BERT,
- zastępują zadanie uzupełniania luk (cloze) z BERT bardziej złożonym zestawem zadań pretreningowych.
Przyjrzyjmy się teraz bliżej idei pretreningu Seq2Seq!
BART
Dokumentacja: https://huggingface.co/docs/transformers/model_doc/bart
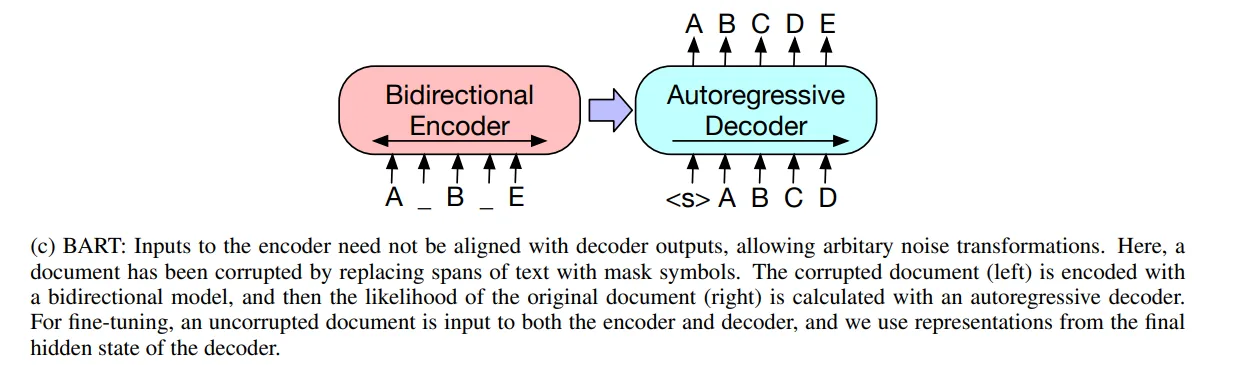
Rysunek z artykułu o BART
BART (Facebook) to dobrze znany model stosowany w wielu implementacjach zadań streszczania tekstu. Jest to autoenkoder odszumiający (denoising autoencoder) o standardowej architekturze seq2seq/tłumaczenia maszynowego z dwukierunkowym enkoderem (jak BERT) i dekoderem działającym od lewej do prawej (jak GPT).
Format sequence-to-sequence oznacza, że BART przyjmuje i zwraca dane w postaci sekwencji. W zadaniu tworzenia streszczeń wejściem jest surowy tekst, a wstępnie wytrenowany model zwraca utworzone streszczenie.
T5
Dokumentacja: https://huggingface.co/docs/transformers/model_doc/t5
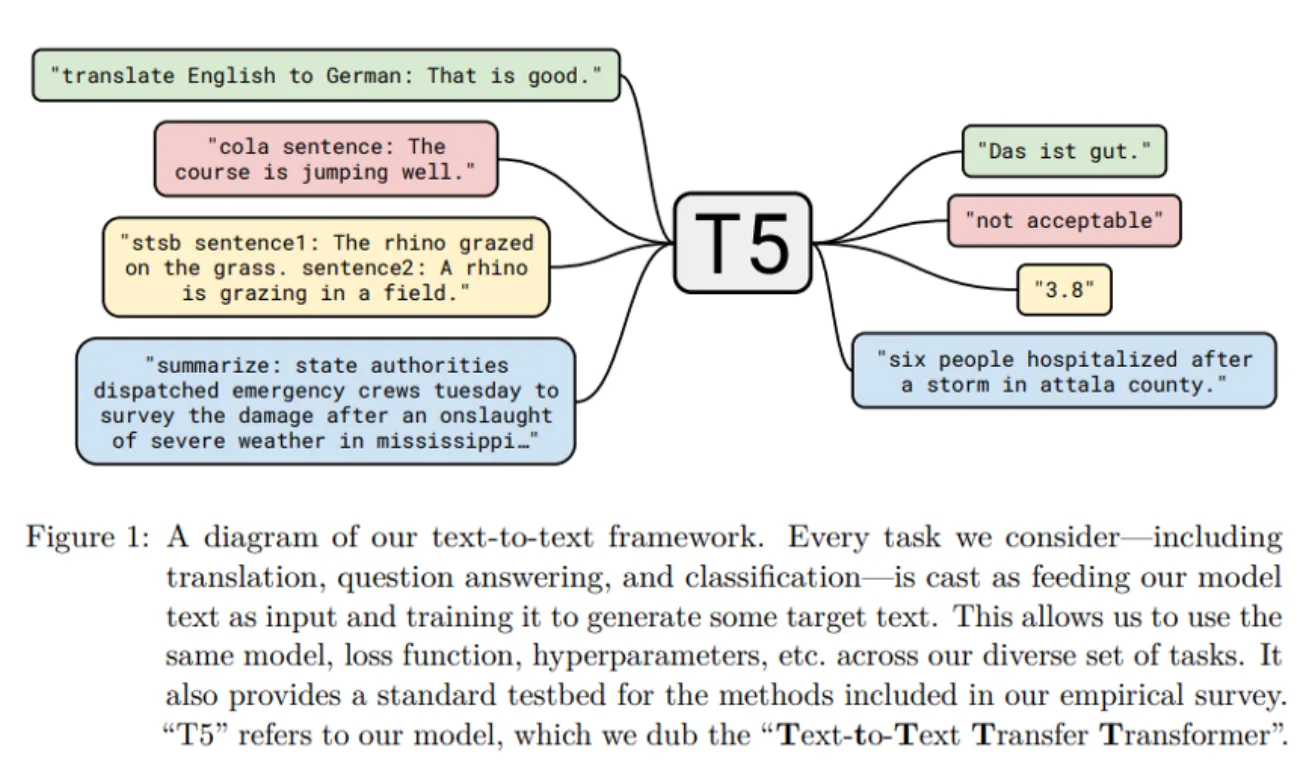
T5 to model Text-to-Text Transfer Transformer od Google. Jest trenowany w sposób end-to-end - na wejściu otrzymuje tekst, a na wyjściu zwraca zmodyfikowany tekst. Dzięki temu formatowi nadaje się do wielu zadań NLP, takich jak streszczanie, odpowiadanie na pytania, tłumaczenie maszynowe i klasyfikacja. Google bardzo ułatwiło testowanie wstępnie wytrenowanych modeli T5 w zadaniach streszczania - wystarczy skorzystać z tego samouczka, aby zobaczyć, jak to działa.
Przyjrzyjmy się modelom T5:
Google udostępniło wstępnie wytrenowane modele frameworka text-to-text T5, które za pomocą uczenia głębokiego wytrenowano na dużym nieoznaczonym korpusie tekstu o nazwie C4 (Colossal Clean Crawled Corpus). C4 to 800 GB oczyszczonego tekstu pozyskanego z sieci.
Google udostępniło wstępnie wytrenowane modele frameworka text-to-text T5, które za pomocą uczenia głębokiego wytrenowano na dużym nieoznaczonym korpusie tekstu o nazwie C4 (Colossal Clean Crawled Corpus). C4 to 800 GB oczyszczonego tekstu pozyskanego z sieci.
- T5-small z 60 milionami parametrów.
- T5-base z 220 milionami parametrów.
- T5-large z 770 milionami parametrów.
- T5-3B z 3 miliardami parametrów.
- T5-11B z 11 miliardami parametrów.
T5 oczekuje prefiksu przed tekstem wejściowym, aby zrozumieć zadanie zlecone przez użytkownika. Na przykład „summarize:” dla streszczania. Jeśli chcesz dowiedzieć się, jak dostroić transformer T5, zajrzyj do tego artykułu.
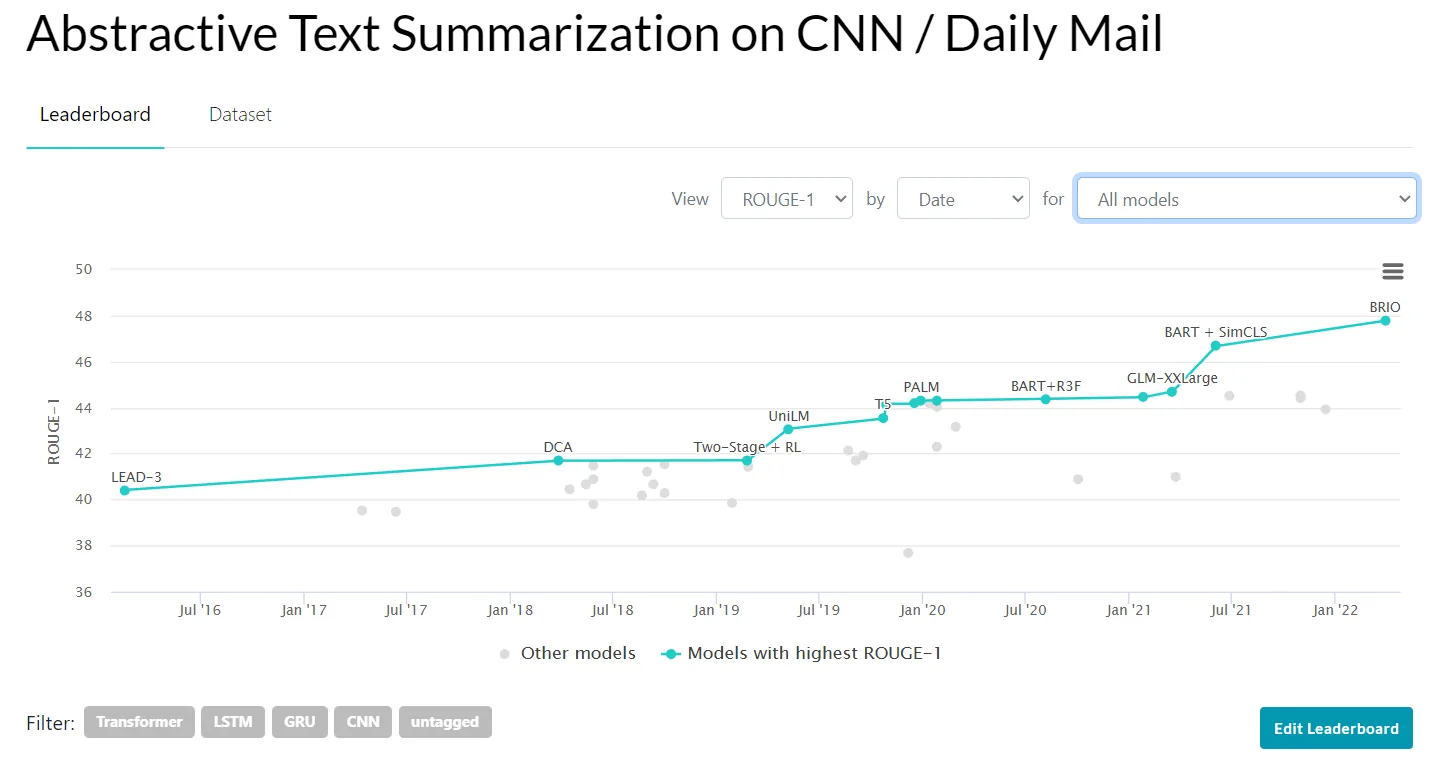
Oprócz poznania popularnych modeli, takich jak BART czy T5, warto śledzić najnowsze modele osiągające wyniki SOTA. Serwis Papers with code ma całą stronę poświęconą abstrakcyjnemu streszczaniu tekstu. Rankingi w sekcji Benchmark służą do śledzenia postępów w tym zadaniu.
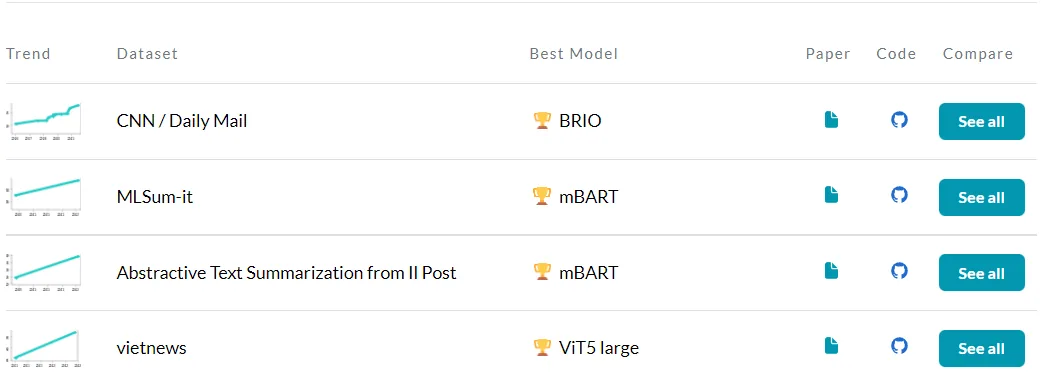
Możesz wybrać zbiór danych i zobaczyć wyniki wybranych modeli dla różnych metryk.
Zalety i wady abstrakcyjnego streszczania tekstu
zalety:
- Jest łatwe do wdrożenia. Możesz szybko zacząć dostrajać istniejące wstępnie wytrenowane modele na własnych danych i otrzymywać wygenerowane streszczenia.
- W przeciwieństwie do podejścia ekstrakcyjnego nie musisz implementować dodatkowych technik wydobywania określonych danych.
wady:
- modele mają skłonność do generowania nieprawdziwych informacji. Dzieje się to na poziomie encji (generowane są dodatkowe encje) albo na poziomie relacji między encjami (kontekst, w którym występują encje, jest generowany błędnie). W artykule Entity-level Factual Consistency of Abstractive Text Summarization autorzy zaproponowali nową metrykę mierzącą spójność faktograficzną generowanych encji. Jeśli interesuje cię ten artykuł, tutaj znajdziesz jego przystępne streszczenie.
- jakość generowanych streszczeń zależy od tego, jak dobry jest twój model. Najlepsze modele potrafią podczas treningu zajmować dużo pamięci, co wymaga mocniejszych kart GPU.
Zbiory danych
Być może słyszałeś już jakąś wersję powiedzenia „Model uczenia maszynowego jest tak dobry, jak dane, którymi go karmimy”. Przyjrzyjmy się temu tematowi, pamiętając, jak ważny jest on dla osiągnięcia dobrego wyniku.
Wiemy już co nieco o istniejących modelach i o tym, gdzie znaleźć ich dokumentację. Być może przetestowałeś już niektóre z nich i chcesz teraz spróbować dostroić któryś, ale nie masz własnego bogatego zbioru danych? Dobrym miejscem do szukania jest papers with code. Dla tego zadania dostępny jest tam łącznie 41 zbiorów danych.
Jeśli chcesz poznać niektóre z najpopularniejszych, zajrzyj do wpisu Część 1: Streszczanie ekstrakcyjne w pigułce
Metryki dokładności i związane z nimi wyzwania
Jak wspomnieliśmy wcześniej, mierzenie jakości generowanych streszczeń może być skomplikowane. Najczęściej używany zestaw metryk do oceny skuteczności modelu streszczającego nazywa się ROUGE.
Jak to działa?
Wynik ROUGE określa, w jakim stopniu wygenerowany tekst pokrywa się ze streszczeniem przygotowanym przez człowieka. Im wyższy wynik, tym większe pokrycie. Metryka uwzględnia ciągi kolejnych tokenów zwane n-gramami. W praktyce najczęściej stosuje się wersje:
- ROUGE 1 - mierzy 1-gramy (pojedyncze słowa)
- ROUGE 2 - mierzy 2-gramy (2 kolejne słowa)
- ROUGE L - mierzy najdłuższą pasującą sekwencję słów za pomocą LCS.
Nooo, to w czym problem?
Ta metryka dobrze sprawdza się do oceny pokrycia, ale nie do mierzenia poprawności faktograficznej. Istnieją 2 niepożądane scenariusze:
- streszczenie niepoprawne faktograficznie, które składa się z tych samych słów co streszczenie referencyjne. Choć inna kolejność słów daje błędne znaczenie, wynik ROUGE jest wysoki.
Streszczenie referencyjne: The dog sat on the blue mat.
Wygenerowane maszynowo: The mat sat on the blue dog.
rouge1: 1.0 rougeL: 0.714 - streszczenie poprawne faktograficznie, które składa się z innych słów, uznanych przez człowieka za poprawne. Pokrycie będzie słabe, co da niski wynik ROUGE.
Streszczenie referencyjne: She lived in a red home.
Wygenerowane maszynowo: She used to have a burgundy house.
rouge1: 0.285 rougeL: 0.285
Ponieważ metryki takie jak ROUGE mają poważne ograniczenia, w wielu artykułach przeprowadza się dodatkowe ręczne porównania alternatywnych streszczeń. Takie eksperymenty trudno porównywać między publikacjami. Dlatego ogłaszanie wyników SOTA wyłącznie na podstawie tych metryk może być problematyczne.
W odpowiedzi na ten problem wprowadzono nowe podejścia:
- wspomnianą wcześniej metodę obliczania spójności faktograficznej generowanych encji Entity-level Factual Consistency of Abstractive Text Summarization
- InfoLM - rodzinę nietrenowanych metryk, które można traktować jak metryki oparte na ciągach znaków, ale które dzięki różnym miarom informacji (np. f-dywergencjom, odległości Fishera-Rao) dobrze radzą sobie z synonimami i parafrazami. Można je uznać za rozszerzenie PRISM. Najlepiej działającą metrykę uzyskuje się z dywergencją AB. Odległość Fishera-Rao, oznaczana jako R, osiąga dobre wyniki w wielu scenariuszach i ma tę zaletę, że nie wymaga parametrów.
Podsumowanie
W tym artykule omówiliśmy wszystkie główne aspekty abstrakcyjnego streszczania tekstu oraz kilka popularnych wyzwań z nim związanych.
Bibliografia
Dokumentacja BART:
https://huggingface.co/docs/transformers/model_doc/bart
BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension :
https://arxiv.org/pdf/1910.13461v1.pdf
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer:
https://arxiv.org/pdf/1910.10683.pdf
Dokumentacja T5:
https://huggingface.co/docs/transformers/model_doc/t5
Modele T5:
https://huggingface.co/models?search=T5
Samouczek dostrajania T5:
https://towardsdatascience.com/fine-tuning-a-t5-transformer-for-any-summarization-task-82334c64c81
Papers With Code | Abstractive text summarization:
https://paperswithcode.com/task/abstractive-text-summarization#datasets
To ROUGE or not to ROUGE?:
https://towardsdatascience.com/to-rouge-or-not-to-rouge-6a5f3552ea45
Entity-level Factual Consistency of Abstractive Text Summarization:
https://arxiv.org/pdf/2102.09130.pdf
Streszczenie powyższego artykułu:
InfoLM:
https://www.aaai.org/AAAI22Papers/AAAI-4389.ColomboP.pdf
Autor: Alicja Golisowicz