

VoiceLab na PolEval i NLP Day
 Autor: VoicelabVoiceLab
Nasz zespół NLP w VoiceLab we współpracy z Uniwersytetem Łódzkim przygotował jedno z zadań konkursu PolEval 2021*.*
PolEval to cykl corocznych konkursów uczenia maszynowego (ML) dla polskiego NLP, inspirowany SemEval. Zgłoszenia rywalizują ze sobą w ramach określonych zadań wybranych przez organizatorów, z wykorzystaniem udostępnionych danych, i są oceniane według ustalonych wcześniej procedur.
Odtwarzanie interpunkcji
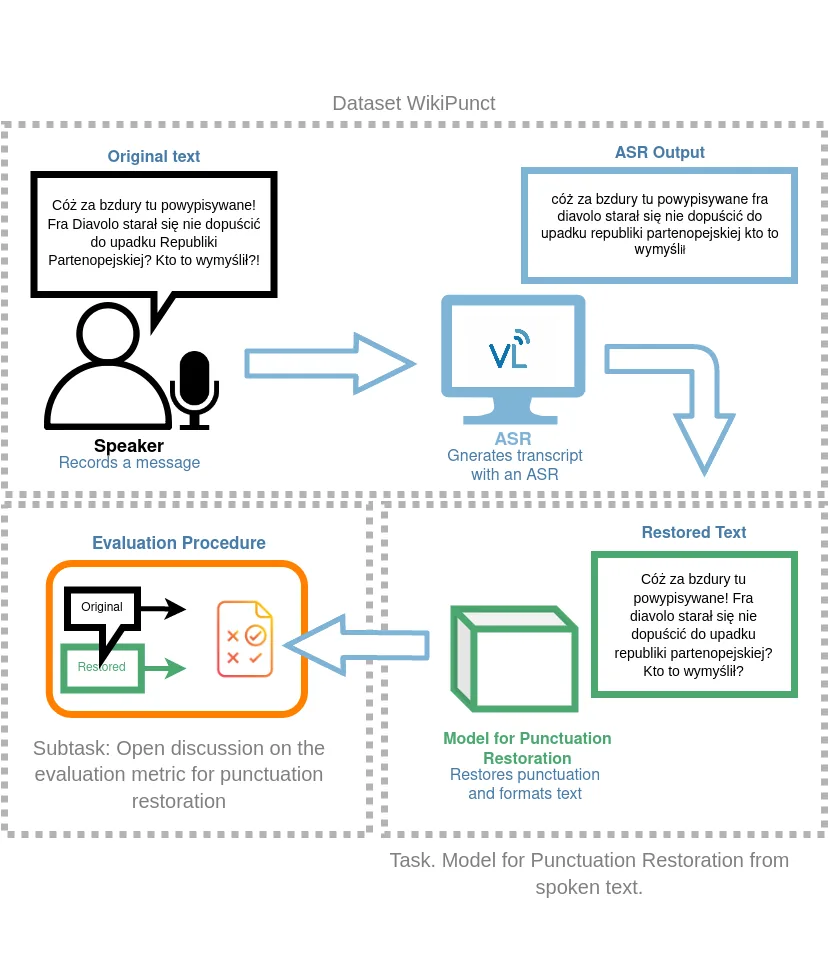
Celem naszego zadania Task 1: Punctuation restoration from read text jest odtworzenie interpunkcji w rozpoznaniach ASR tekstów czytanych na głos. Wraz z zadaniem udostępniliśmy zbiór danych WikiPunct, składający się z ponad 1500 nagrań i 32 000 tekstów. WikiPunct to zebrany metodą crowdsourcingu zbiór tekstów i nagrań stron polskiej Wikipedii czytanych na głos przez polskich lektorów. Zbiór dzieli się na dwie części: konwersacyjną (WikiTalks) i informacyjną (WikiNews). W przygotowanie części audio zaangażowanych było ponad sto osób. Łączna długość nagrań sięga prawie trzydziestu sześciu godzin, wliczając zbiór testowy. Zadbaliśmy o zrównoważenie proporcji głosów męskich i żeńskich.
Więcej o danych i zadaniu przeczytasz tutaj. Dane opublikowaliśmy w tym repozytorium (repozytorium). Wzorcowa anotacja danych testowych (gold standard) została opublikowana w gałęzi „secret”.
NLP Day
Odwiedź nas 25 października na konferencji NLP Day, na ścieżce PolEval. Najpierw przedstawimy nasze zadanie, a następnie czterech pierwszych zwycięzców opisze swoje podejścia.
Jako oficjalny partner zapraszamy do rejestracji na konferencję AI & NLP z naszym specjalnym kodem promocyjnym: FREE524, który daje bezpłatny dostęp do wszystkich prezentacji podczas pierwszych dwóch dni konferencji.