

Jak przygotować zbiór danych do neuronowej syntezy mowy - część 1: przygotowanie tekstu
 Autor: VoicelabVoiceLab
W ostatnich latach systemy syntezy mowy (TTS) oparte na uczeniu głębokim prześcignęły inne podejścia pod względem jakości i naturalności mowy. W 2017 roku Google zaproponował system end-to-end Tacotron2, zdolny do generowania mowy wysokiej jakości, zbliżonej do ludzkiego głosu. Od tego czasu syntezatory oparte na uczeniu głębokim stały się gorącym tematem. Wielu badaczy i firm opublikowało własne architektury TTS end-to-end bazujące na Tacotron2, takie jak FastPitch i HifiGan.
Mimo trwających badań nad modelami TTS typu few-shot najlepsze architektury wciąż wymagają do treningu stosunkowo dużych zbiorów danych. Co więcej, zarówno generatory spektrogramów, jak i wokodery są wrażliwe na błędy i niedoskonałości danych treningowych.
Istnieją zbiory danych w domenie publicznej, takie jak LJSpeech i M-AILABS. Jednak tylko nieliczne z nich zapewniają wystarczająco dobrą jakość, zwłaszcza w językach innych niż angielski.
W tym artykule przedstawimy nasze podejście do budowy własnego zbioru danych przeznaczonego dla modelu syntezy mowy opartego na uczeniu głębokim. Wyjaśnimy naszą metodologię i podpowiemy, jak zapewnić wysoką jakość zarówno transkrypcji, jak i nagrań.
Podzieliliśmy go na dwie części. Pierwsza skupia się na tekście: podpowiada, skąd brać transkrypcje do nagrań i jak je przygotować. Druga część dotyczy głównie nagrywania i przetwarzania dźwięku.
Pamiętaj, że języki się od siebie różnią. Niektóre z naszych wniosków mogą nie dotyczyć wszystkich z nich.
Wybór źródeł
Zacznijmy od początku: potrzebujemy źródła danych tekstowych. Najłatwiej dostępnym i prawdopodobnie najczęściej używanym źródłem tekstów są książki z domeny publicznej.
Zgadzamy się, że to świetne źródło, ale trzeba wziąć pod uwagę kilka kwestii:
- Wiele książek z domeny publicznej jest starych, przez co transkrypcje mogą być archaiczne, zwłaszcza w językach, które zmieniały się na przestrzeni lat.
- Może w nich brakować trudnych słów, a ich słownictwo może być mało zróżnicowane (np. w książkach dla dzieci).
- Mogą zawierać zbyt mało znaków interpunkcyjnych (np. w książkach przyrodniczych jest bardzo mało pytań).
Ponieważ modele TTS uczą się mapować n-gramy na dźwięki, jeśli w zbiorze danych brakuje niektórych z nich (co może wynikać z punktu 1 lub 2), model będzie miał problemy z ich wymową. Będzie to szczególnie widoczne w słowach o trudnej lub nietypowej wymowie (często mówi się tu o pokryciu fonemów, phoneme coverage). Trzeci punkt może powodować problemy, takie jak brak intonacji pytającej czy dziwne zachowanie w obliczu dużej liczby znaków interpunkcyjnych - np. przy wyliczeniach.
Dlatego, aby zapewnić dobre pokrycie fonemów i wystarczającą ilość interpunkcji, zalecamy różnicowanie źródeł transkrypcji.
Każde źródło i gatunek mają swoją specyfikę, którą warto uwzględnić przy budowie zbioru danych. Na przykład wywiady zawierają średnio znacznie więcej pytań niż serwisy informacyjne czy artykuły przyrodnicze. Opowiadania z dużą ilością dialogów mają więcej interpunkcji. Prace naukowe częściej zawierają specjalistyczne słownictwo. Teksty prasowe będą prawdopodobnie wymagały więcej normalizacji (więcej o tym później), niektóre źródła mogą zawierać dużo słów obcych (których chcemy unikać) i tak dalej.
Jeśli zamierzamy używać modelu TTS do czegoś bardziej konkretnego, dodanie transkrypcji ze słownictwem specyficznym dla danej domeny również może poprawić wynik.
Ile danych wystarczy?
Jak sprawdzić, ile godzin nagrań uzyskamy z zebranego tekstu? Do tego potrzebne jest tempo mowy. Tempo mowy to liczba słów wypowiadanych w ciągu minuty (words per minute, wpm), a jego średnie wartości zależą od kontekstu i języka.
- Prezentacje: od 100 do 150 wpm przy komfortowym tempie
- Rozmowa: od 120 do 150 wpm
- Audiobooki: od 150 do 160 wpm, co jest górną granicą, przy której ludzie komfortowo słyszą i wymawiają słowa
- Prowadzący audycje radiowe i podcasterzy: od 150 do 160 wpm
- Licytatorzy na aukcjach: potrafią mówić z prędkością ok. 250 wpm
- Komentatorzy: od 250 do 400 wpm
Źródło
Jak widać, najlepsze tempo mowy dla systemu TTS ogólnego przeznaczenia to ok. 150 słów na minutę. Tempo mowy w LJSpeech wynosi ok. 140 wpm. Oczywiście warto uwzględnić naturalne tempo mowy lektorów, aby brzmieli autentycznie.
Po ustaleniu idealnego tempa mowy długość zbioru danych można oszacować za pomocą poniższego skryptu w Pythonie.
import os

DIR_PATH = '/path/to/transcriptions/'  # Path to the directory with our transcriptions
SPEECH_RATE = 120  # Speech rate (words per minute)

transcriptions = {}
word_count = 0

for current_path, folder, files in os.walk(DIR_PATH):
    for file_name in files:
        path = os.path.join(current_path, file_name)
        with open(path) as transcription_file:
            transcription = transcription_file.read()
            for punct in string.punctuation:
                transcription = transcription.replace(punct, ' ')  # Replace punctuation with whitespaces
            transcription = re.sub(' {2,}', ' ', transcription)  # Delete repeated whitespaces
            transcriptions[path] = len(transcription.split())
            word_count += transcriptions[path]
print(f"There are {word_count} words in total, which is around {word_count/SPEECH_RATE} minutes.")
Skrypt po prostu sumuje liczbę słów we wszystkich transkrypcjach i dzieli ją przez szacowane tempo mowy lektora.
Wstępne przetwarzanie transkrypcji
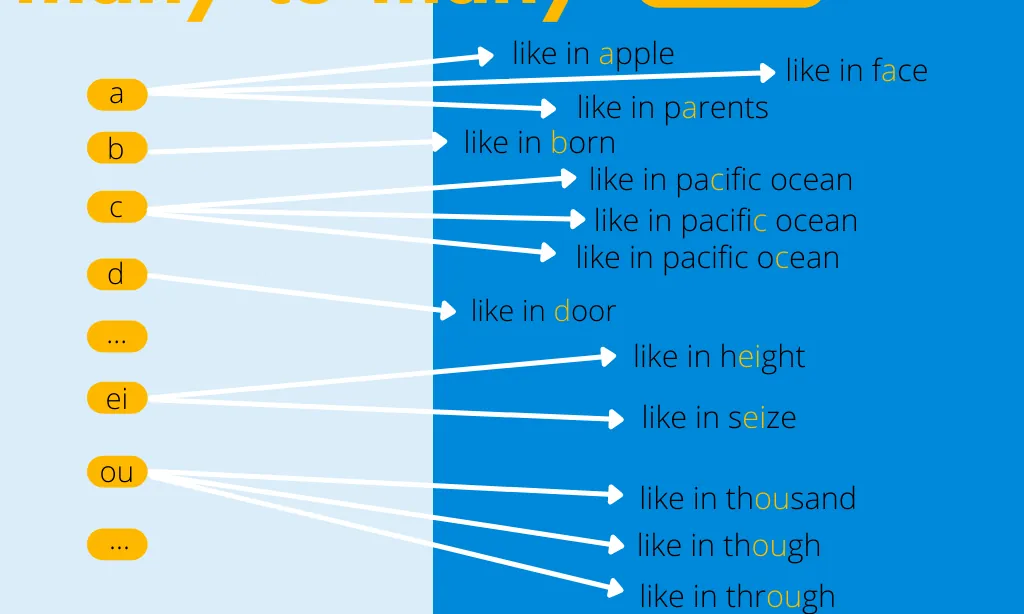
Syntezę mowy warto traktować jako problem mapowania wiele-do-wielu. Chcemy, aby model nauczył się zamieniać litery na dźwięki, dlatego ważna jest wielkość przestrzeni wszystkich możliwych mapowań między fonemami/literami a dźwiękami. Jak wspomnieliśmy wcześniej, generator spektrogramów bez fonemizera może działać lepiej na polskim zbiorze danych niż na angielskim zbiorze tej samej wielkości. Wydaje się, że łatwiej wytrenować model TTS dla języków takich jak polski czy hiszpański, których systemy ortograficzne są bliższe spójnej reprezentacji fonemicznej.
Poniżej przedstawiamy wizualizację problemu wiele-do-wielu dla angielskiego TTS.
Aby zminimalizować liczbę mapowań między znakami a dźwiękami, powinniśmy znormalizować zbiór danych. Po tym kroku powinien on zawierać tylko słowa i znaki interpunkcyjne: musimy zwerbalizować cyfry i skróty, zapisać liczby słownie i rozwinąć skróty do pełnej postaci.
| Surowy tekst | Po normalizacji |
|---|---|
| David Bowie was born on 8 Jan 1947. | David Bowie was born on eighth January nineteen forty-seven. |
| Bakery is on 47 Old Brompton Rd. | Bakery is on forty-seven Old Brompton Road |
Ponadto musimy zadbać o zapożyczenia, czyli słowa z innych języków, które mogą pojawić się w naszych tekstach. Zapożyczenia należy zapisywać tak, jak się je słyszy.
| Surowy tekst | Po normalizacji |
|---|---|
| She yelled - Garçon! | She yelled - Garsawn! |
| Causal greeting in Polish is “cześć”. | Casual greeting in Polish is “cheshch”. |
Oczywiście można z tego zrezygnować, jeśli w zbiorze danych nie ma zapożyczeń albo jeśli narzucasz lektorom konkretny sposób czytania, ale dla ich wygody i prostoty lepiej po prostu zapisywać zapożyczenia tak, jak się je słyszy.
Kolejnym problematycznym elementem normalizacji języka są skrótowce. W naszym zbiorze danych zdecydowaliśmy, że skrótowce czytane jako litery będą rozdzielane znakiem „-”.
| Surowy tekst | Po normalizacji |
|---|---|
| UK | UK |
| OPEC | OPEC |
Jak w przykładzie powyżej, OPEC czyta się jako słowo, a nie jako litery, więc nie trzeba go rozdzielać. Ostatnia wskazówka dotycząca normalizacji to wybór zestawu symboli. Pozwala to odfiltrować niepożądane symbole, co sprawi, że dalsze etapy przetwarzania będą łatwiejsze i prostsze.
Po zebraniu i przetworzeniu tekstu czas nagrać i złożyć nasz zupełnie nowy zbiór danych.
Autorzy: Marcin Walkowski, Konrad Nowosadko, Patryk Neubauer
Następna część cyklu: Jak przygotować zbiór danych do neuronowej syntezy mowy - część 2: nagrania i przetwarzanie dźwięku